


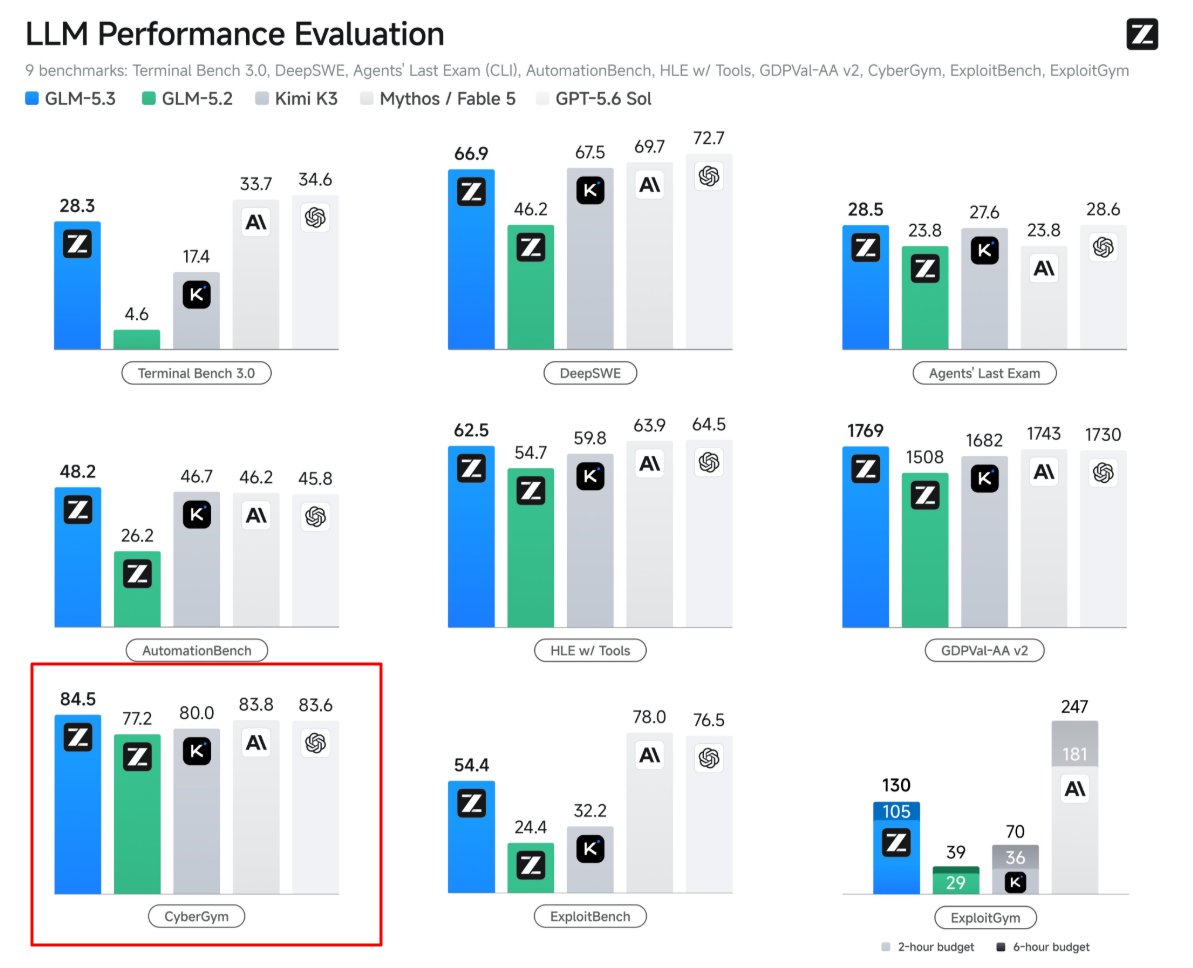

Çin merkezli yapay zeka şirketi Z.ai, yeni nesil büyük dil modeli GLM-5.3'ün siber güvenlik değerlendirmelerinde Anthropic'in Mythos 5 modelini geride bıraktığını duyurdu. 743 milyar parametreli model, özellikle siber güvenlik açıklarını tespit etme konusunda iddialı sonuçlar elde etti. GLM-5.3'ün kodlama yeteneklerinde ciddi bir iyileşme gözlemlendi.
- Çin merkezli yapay zeka şirketi Z.ai, yeni nesil büyük dil modeli GLM-5.3'ün siber güvenlik değerlendirmelerinde Anthropic'in Mythos 5 modelini geride bıraktığını duyurdu.
- 743 milyar parametreli model, özellikle siber güvenlik açıklarını tespit etme konusunda iddialı sonuçlar elde etti.
- GLM-5.3'ün kodlama yeteneklerinde ciddi bir iyileşme gözlemlendi.
Çin merkezli yapay zeka şirketi Z.ai, yeni nesil büyük dil modeli GLM-5.3'ün siber güvenlik değerlendirmelerinde Anthropic'in Mythos 5 modelini geride bıraktığını duyurdu.
GLM-5.3 Siber Güvenlik Testlerinde Anthropic’in Mythos 5 Modelini Geride Bıraktı
Çin merkezli yapay zeka şirketi Z.ai, yeni nesil büyük dil modeli ‘ün siber güvenlik değerlendirmelerinde ’in Mythos 5 modelini geride bıraktığını duyurdu. 743 milyar parametreli model, özellikle siber güvenlik açıklarını tespit etme konusunda iddialı sonuçlar elde etti.
GLM-5.3 Coding Benchmark Sonuçları: Büyük Sıçrama
GLM-5.3’ün kodlama yeteneklerinde ciddi bir iyileşme gözlemlendi. Terminal Bench 3.0 testinde model, 4.6 puanından 28.3 puana yükselirken; DeepSWE testinde 46.2’den 66.9’a çıktı.
CyberGym ve ExploitBench Sonuçları: Güçlü ve Zayıf Yönler
Z.ai’nin paylaştığı verilere göre, GLM-5.3 siber güvenlik değerlendirmelerinde iki farklı test setinde farklı sonuçlar elde etti: CyberGym‘de %84.5 başarı oranı ile Mythos 5 (%83.8) ve (%83.6) önünde yer aldı. Ancak ExploitBench‘te %54.4 ile geride kaldı; Mythos 5 (%78.0) ve GPT-5.6 Sol (%76.5) bu kategoride daha başarılı oldu.
ExploitGym Performansı: Uzun Görev Zincirlerinde Zorluk
ExploitGym testlerinde GLM-5.3, 2 saat içinde 105 görev tamamladı ve bu sayı 6 saatte 130’a yükseldi. Ancak Anthropic’in Mythos 5 modeli aynı sürelerde sırasıyla 181 ve 247 görev tamamladı.
Eğitim Yaklaşımı ve Gelecek Planları
Z.ai, GLM-5.3’ün eğitim ortamlarının giderek çok günlük mühendislik çalışmalarını taklit ettiğini, modelin uzun görev zincirlerinde teşhis, düzenleme, test ve kurtarma döngülerini yönetmesi gerektiğini belirtti. Şirket, model ağırlıklarını iki haftalık güvenlik incelemesinin ardından yayınlamayı planlarken, en hassas siber güvenlik işlevlerini yalnızca doğrulanmış kullanıcılarla sınırlandıracak.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/glm-5-3-siber-guvenlik-testlerinde-anthropic-mythos-5i-geride-birakti-84-5-cybergym/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.
Yorum yazın