
Kısaca · 3 madde
- 1Agent Skills ise Yariyor mu?
- 2Yeni bir arastirma, AI Agent Skills sistemlerinin performans uzerindeki gercek etkisini analiz etti.
- 3Arastirmacilar, WebDev-Skills-Bench yontemiyle kapsamli bir test gerceklestirdi.
Agent Skills ise Yariyor mu? Yeni Benchmark Arastirmasi Supriz Sonuclar Ortaya Koydu
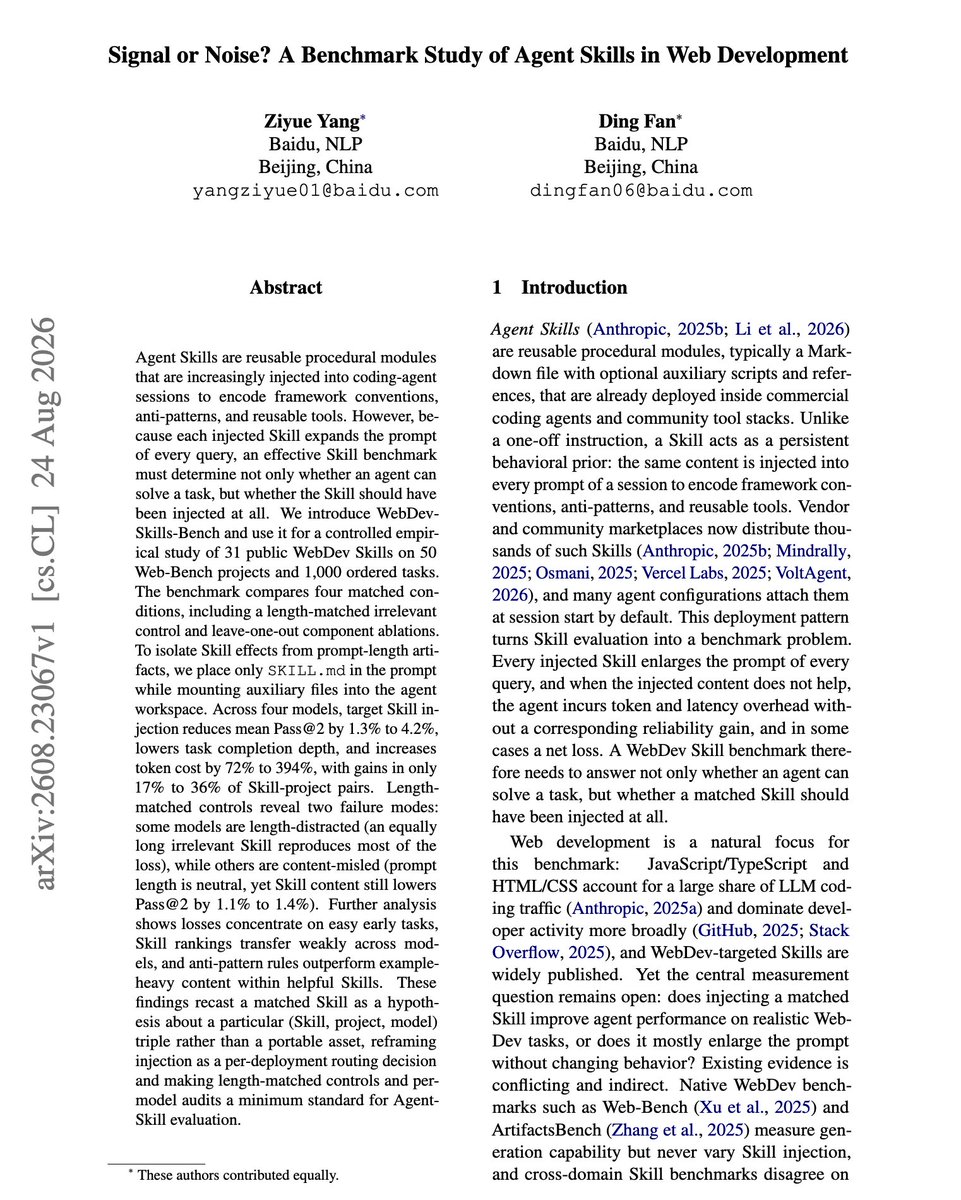
Yeni bir arastirma, AI Agent Skills sistemlerinin performans uzerindeki gercek etkisini analiz etti. Sonuclar, bir cok yaygin kabulun aksine, Skills sistemlerinin cogu zaman performansi düsürdügünü ortaya koydu. Web gelistirme alaninda 31 farkli Agent Skill, 50 proje ve 1.000 gorev uzerinde sinandi.
Test Nasil Yapildi?
Arastirmacilar, WebDev-Skills-Bench yontemiyle kapsamli bir test gerceklestirdi. 31 genel kullanima acik WebDev Skills, 50 farkli Web projesi ve 1.000 sirali gorev uzerinde calistirildi. Sonuclarin guvenilirligi icin, etkili uzunlukdaki ilgisiz kontrol gruplari ile karsilastirma yapildi.
Temel Sonuclar: Basari Dustu, Maliyet Artti
Testlerin temel bulgulari oldukca dikkat cekici:
- Hedef Skill’in eklenmesi, Pass@2 basarisini yuzde 1.3 ile 4.2 arasinda dusurdu
- Gorev tamamlama derinligi belirgin sekilde azaldi
- Maliyet yuzde 72 ile 394 arasinda artti
- Kazanclar sadece yuzde 17 ile 36 arasindaki Skill-proje ikililerinde gorumaya basladi
Iki Farkli Basarisizlik Modu Tespit Edildi
Arastirmacilar, basarisizliklarin iki farkli moddan kaynaklandigini belirledi:
1. Uzunluk Kaynakli Dikkat Dagilimi: Bazi modeller, eklenen Skill’in uzunlugundan olumsuz etkileniyor. Ayni uzunluktaki ilgisiz bir Skill bile benzer kayip üretiyor.
2. Icerik Yaniltmasi: Diger modellerde ise Skill uzunlugu nötr kalip, yine de icerik nedeniyle 1.1 ile 1.4 puan arasinda kayip yaşaniyor.
Daha Fazla Kayip Kolay Gorevlerde
Ilginc bir sekilde, kayiplar cogunlukla kolay ve erken gorevlerde toplaniyor. Bu da gelistiricilerin dikkatli olmasi gereken bir noktaya isaret ediyor. aihaber.org AI ajanlari bolumunde bu konudaki gelismeleri takip edebilirsiniz.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/agent-skills-benchmark-performans/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın