
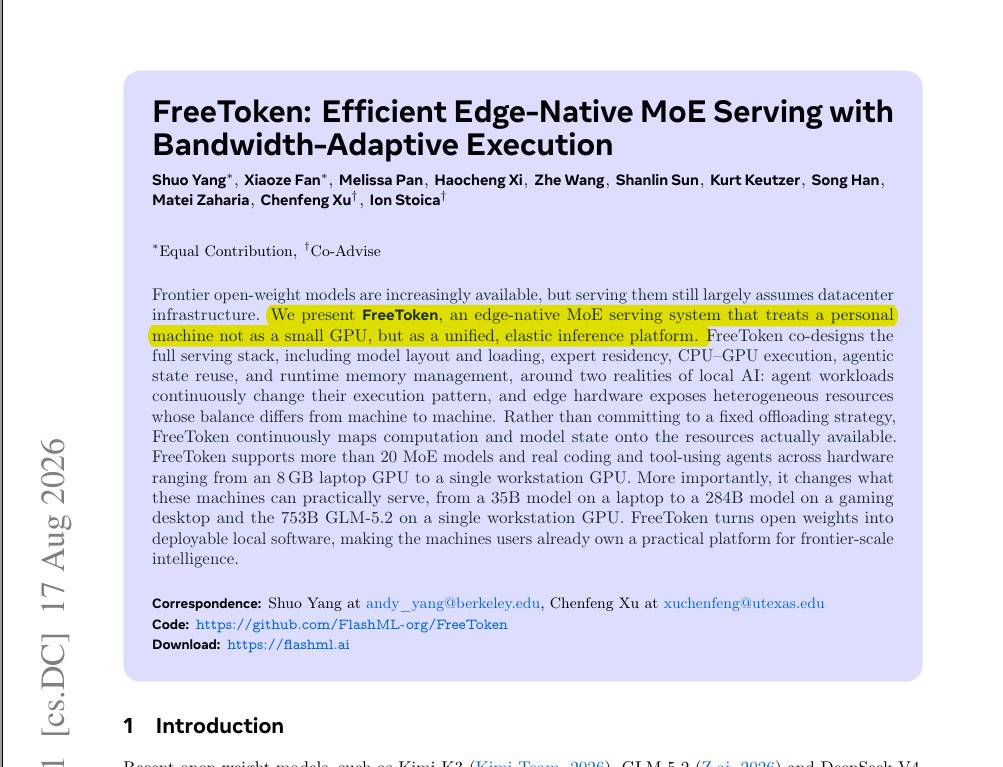
Berkeley ve Texas Üniversitesi araştırmacıları, yapay zeka modellerinin yerel makinelerde çalıştırılmasinde devrim niteliğinde bir atılım gerçekleştirdi. FreeToken adı verilen yeni sistem, 8 GB ekran kartlı bir oyun dizüstü bilgisayarında 35 milyar parametreli MoE modelini saniyede 39,3 token hızında çalıştırabildiğini gösteriyor. Bu sonuç, üretimde Codex’ten bile hızlı bir performans.
FreeToken Nedir?
FreeToken, büyük open-source modelleri sıradan donanımlarda verimli şekilde çalıştırmak için tasarlanmış yeni bir MoE (Mixture of Experts) sunucu motoru. Geleneksel sistemlerin aksine, hangi uzmanların GPU’da kalacağını yükleme sırasında tahmin etmek yerine, FreeToken GPU önbelleğinin yönlendiricinin sorguladığı öğeyi takip etmesine izin veriyor.
Teknik Yenilikler
FreeToken’in temel yenilikleri şunlardır:
- Bandwidth-Adaptive Execution (q* Policy): PCIe ve bellek bant genişliklerinin gerçek zamanlı profillemesiyle önbellek kaçırma oranlarını yüzde 62’den yüzde 16’ya düşürüyor
- Semantic-Aware Caching: Aracı framework sınırlarında yinelenen durum kontrol noktaları oluşturarak bağlam yeniden hesaplamasını minimize ediyor
- Elastic Edge Resource Management: KV cache ve uzman cache arasında dinamik GPU bellek tahsisi sağlıyor, motoru yeniden başlatmaya gerek kalmıyor
Performans Sonuçları
Araştırmacıların testlerinde elde ettiği bulgular şöyle:
- RTX 5090 masaüstü GPU’sunda Qwen3.6-35B-A3B: 77-83 token/saniye
- 8 GB RTX 4060 dizüstü bilgisayarda 35B model: 39,3 token/saniye
- RTX PRO 6000 iş istasyonunda 753B GLM-5.2: 14,9 token/saniye
- İlk token gecikmesi (TTFT): FreeToken 44 saniyenin altında sabit kalırken llama.cpp 232 saniye, KTransformers 946 saniye
Neden Önemli?
Bu gelişme, yapay zeka modeli çalıştırmanın artık pahalı bulut sunucularına bağımlı olmadığını gösteriyor. Yerel makinelerde yüksek performans elde etmek, bireysel geliştiricilerin ve küçük işletmelerin büyük modellere erişimini ciddi şekilde kolaylaştırıyor.
Karşılaştırmalı Performans
FreeToken, llama.cpp’e kıyasla 1,5x ila 2,3x daha yüksek kod çözme verimi sunuyor. Özellikle RTX 4060 dizüstü bilgisayarda 1,8x, RTX 5090 masaüstünde ise 2,1x performans artışı sağlıyor. Uzun çoklu dönüşlü aracı iş yüklerinde rakipler yüzde 30-40 arasında performans kaybı yaşarken FreeToken performansını yalnızca yüzde 12 oranında düşürüyor.
Kaynak: @rohanpaul_ai, arXiv
Henüz yorum yok. İlk yorumu siz yapın!