
Kısaca · 3 madde
- 1GLM-5.3, ayni baz model (GLM-5.2) uzerinden yalnizca post-training olceklendirmesiyle onemli yetenek artisi gosterdi.
- 2Bu faktorler birlikte degerlendirildiginde, modelin yalnizca bilgi depolamasi degil, bu bilgiyi gercek dunya gorevlerinde etkin sekilde kull…
- 3GLM-5.3 hakkinda detayli bilgi icin @kimmonismusuern X paylasimini inceleyebilirsiniz.
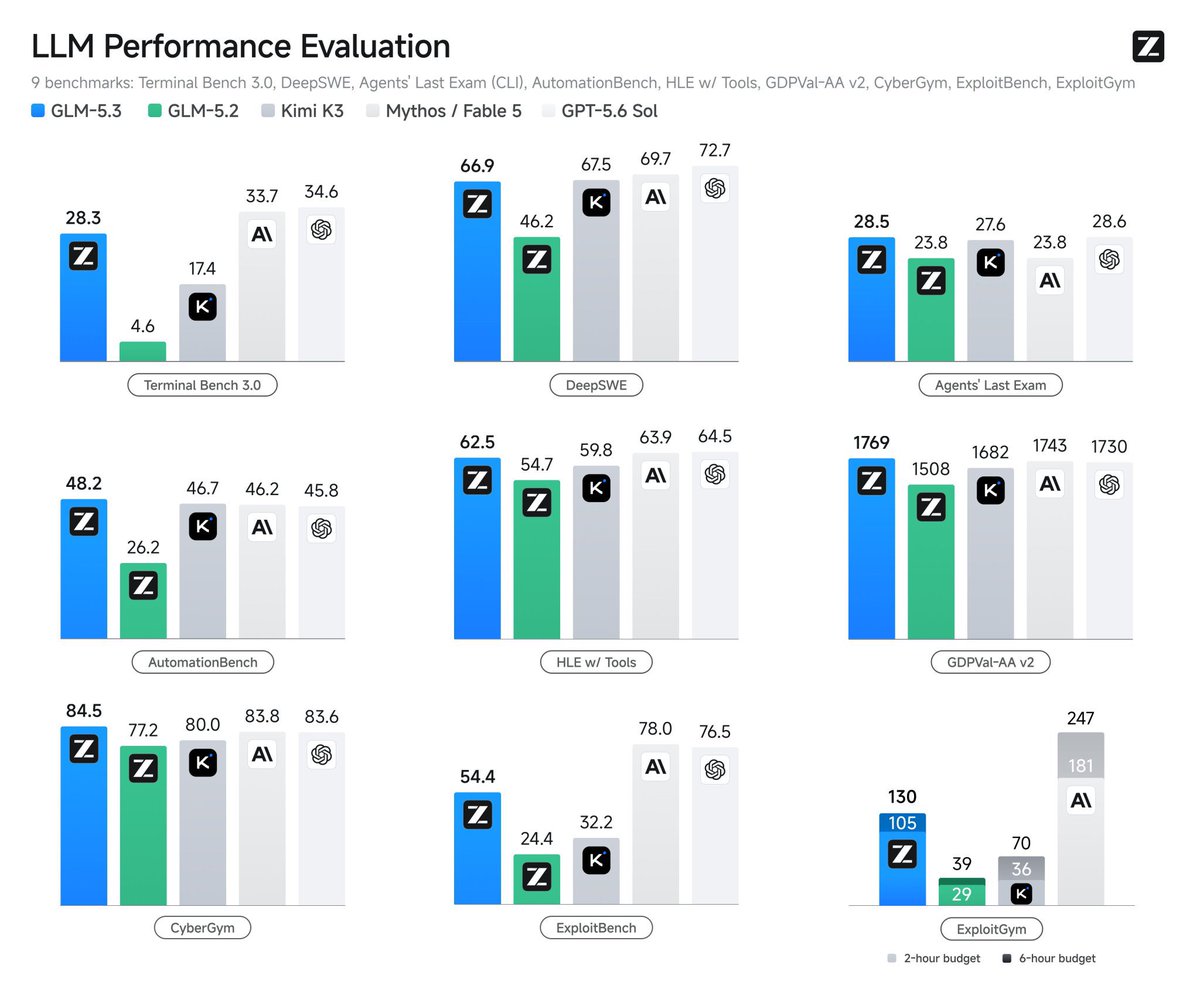
, ayni baz model () uzerinden yalnizca post-training olceklendirmesiyle onemli yetenek artisi gosterdi. Yapay zeka guvenlik toplulugunda buyuk yanki uyandiran bu bulus, on egitim (pre-training) ve son egitim (post-training) sureclerinin model performansindaki rolunu yeniden dusunmeye davet ediyor.
Post-Training Neden Bu Kadar Onemli?
GLM-5.3uern en dikkat cekici yonu, tamamen post-training olceklendirmesiyle elde edilen bu performans artisi. Zai ekibinin paylastigi bilgilere gore, iyilestirmeler dort ana faktor uzerinden gerceklesti: daha fazla yurutulebilir ortam (executable environments), daha uzun gorevler, daha guclu dogrulayicilar (verifiers) ve olceklendirilmis pekistirmeli ogrenme (RL).
Bu faktorler birlikte degerlendirildiginde, modelin yalnizca bilgi depolamasi degil, bu bilgiyi gercek dunya gorevlerinde etkin sekilde kullanmasi hedeflenmis.
ExploitBenchte 30 Puanlik Arti$
Modelin ExploitBench performansi, post-training iyilestirmelerinin somut etkisini gosteriyor. Onceki versiyon GLM-5.2de %24.4 olan basari orani, GLM-5.3te %54.4e yukseldi. ExploitGymde ise 2 saat icinde 105 gorev tamamlandi; onceki versiyon bu gorevlerden yalnizca 29unu tamamlayabilmisti.
Acık Kaynak Modeller icin Duyrulari
, acık kaynak yapay zeka modellerinin ne kadar hizli frontier performansa yaklastigini kanitladi. Bu durum, ABD guvenlik regulatorlerinin acık kaynak modeller icin yeni duzenter getirmesi bekleniyor. Ozelikle siniflandirilmis cyber benchmarklar ve covered frontier models icin gonullu on-yayinlama sureci gibi onlemler, bu duzenlemelerin ilk isaretleri olarak degerlendiriliyor.
hakkinda detayli bilgi icin @kimmonismusuern X paylasimini inceleyebilirsiniz.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/glm-5-3-post-training-scaling-siber-guvenlik/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın