
Kısaca · 2 madde
- 1Yeni bir akademik calisma, AI model degerlendirmelerinde kritik bir sorunu gun yuzune cikariyor: LLM benchmark harness sistemleri, modelleri…
- 2DAIR.AI arastirmacisi V.S.
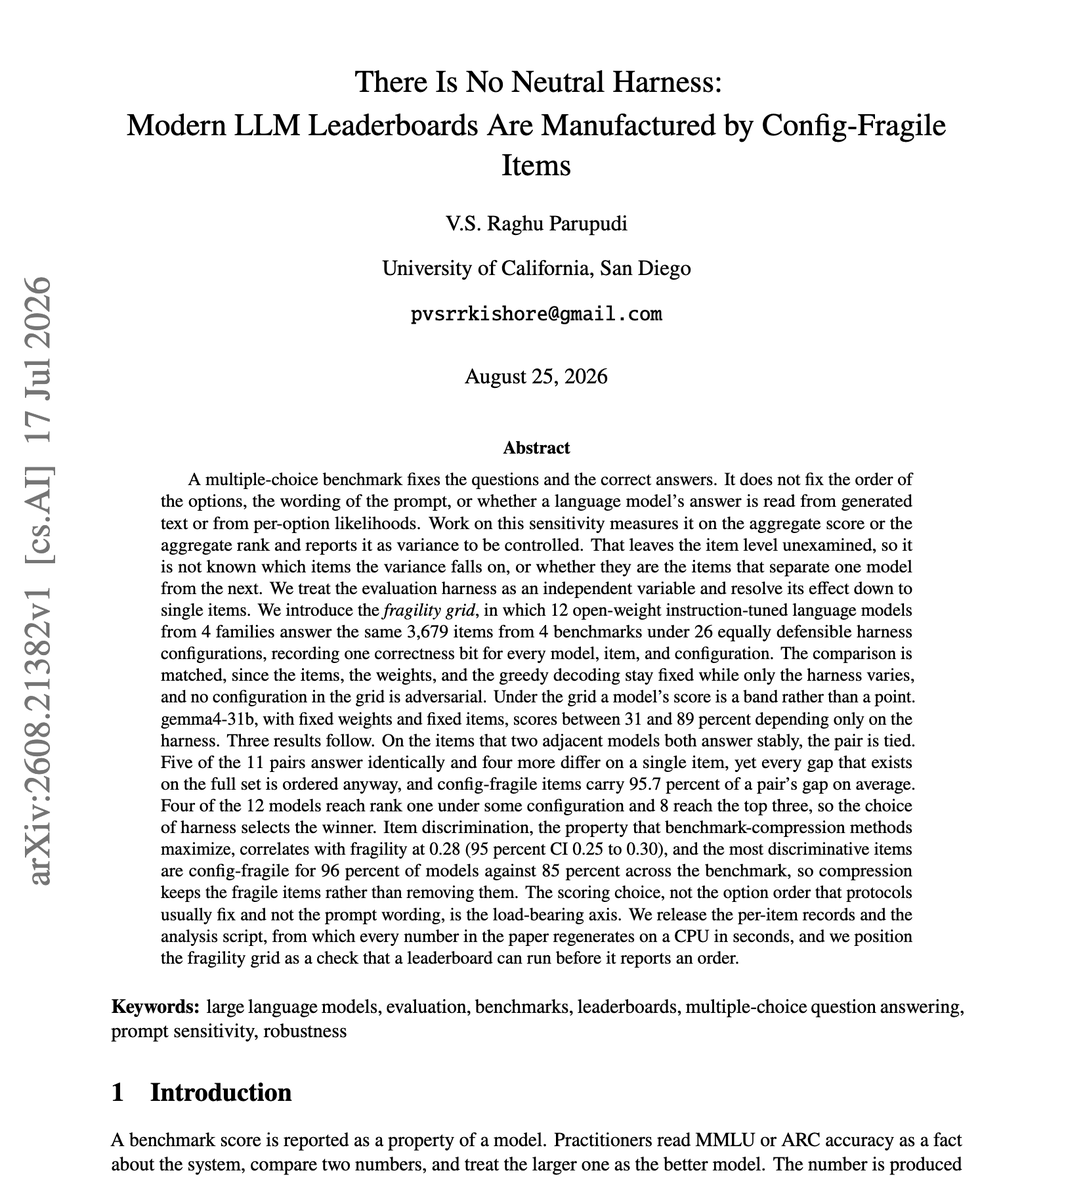
Yeni bir akademik calisma, AI model degerlendirmelerinde kritik bir sorunu gun yuzune cikariyor: LLM benchmark harness sistemleri, modellerin gercek yeteneklerini degil, yapilandirma tercihlerini oliyor.
DAIR.AI arastirmacisi V.S. Raghu Parupudi tarafindan yayimlanan calisma, modern LLM liderlik tablolarinin buyuk olcude yapay olarak uretildigini kanitliyor.
Arastirma Nasil Yapildi?
Calisma, 4 farkli model ailesinden 12 acik agirlikli talimat-hasar edilmis LLMi 26 farkli esit derecede savunulabilir harness yapilandirmasi altinda test etti. Tum modeller, ARC, HellaSwag, MMLU ve TruthfulQA benchmarklarindan ayni 3.679 soruyu yanitladi.
gemma4-31b: Yuzde 31 ile Yuzde 89 Arasinda
Arastirmanin en carpici bulgusu, gemma4-31b modelinin yalnizca harness degisimiyle yuzde 31 ile yuzde 89 arasinda skor alabilmesiydi.
Dort Farkli Model Birinci Olabiliyor
12 test edilen model arasindan 4 farkli model, yalnizca harness yapilandirmasini degistirerek birinci siraya yerlesebildi. Yuzde 95,7 oraninda performans farki, yapilandirma-kirilgan sorulardan kaynaklaniyor.
Scoring Metodu: Asil Kirilgan Eksen
Arastirmacilar, secenek siralamasinin yaygin benchmark protokollerinin duzeltmeye calistigi faktor olmadigini, asil yuk tasimaci eksenin scoring metodu oldugunu tespit etti.
Sikistirilmis Benchmarklar Paradoxu
Endustri, maliyet ve hiz avantaji icin benchmarklari sikistirma egiliminde. Ancak bu calisma, sikistirilmis benchmarklarin en kirilgan maddeleri korudugunu ortaya koyuyor.
Kaynak: arxiv.org/abs/2608.21382
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/llm-benchmark-harness-yanliligi-ai-model-skorlari-yapay-olarak-uretiliyor/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın