
Kısaca · 3 madde
- 1Yapay zeka alanında kritik bir araştırma, LLM judge sistemlerinin uzman insan değerlendirmeleriyle ciddi sapmalar gösterdiğini ortaya koydu.
- 2LLM judge, büyük dil modellerinin bir başka dil modelinin ürettiği cevapları değerlendirmek için kullandığı bir sistem.
- 3Araştırmacılar, 300'den fazla tam insan danışman tarafından yazılmış gerçekçi diyalog kullandı.
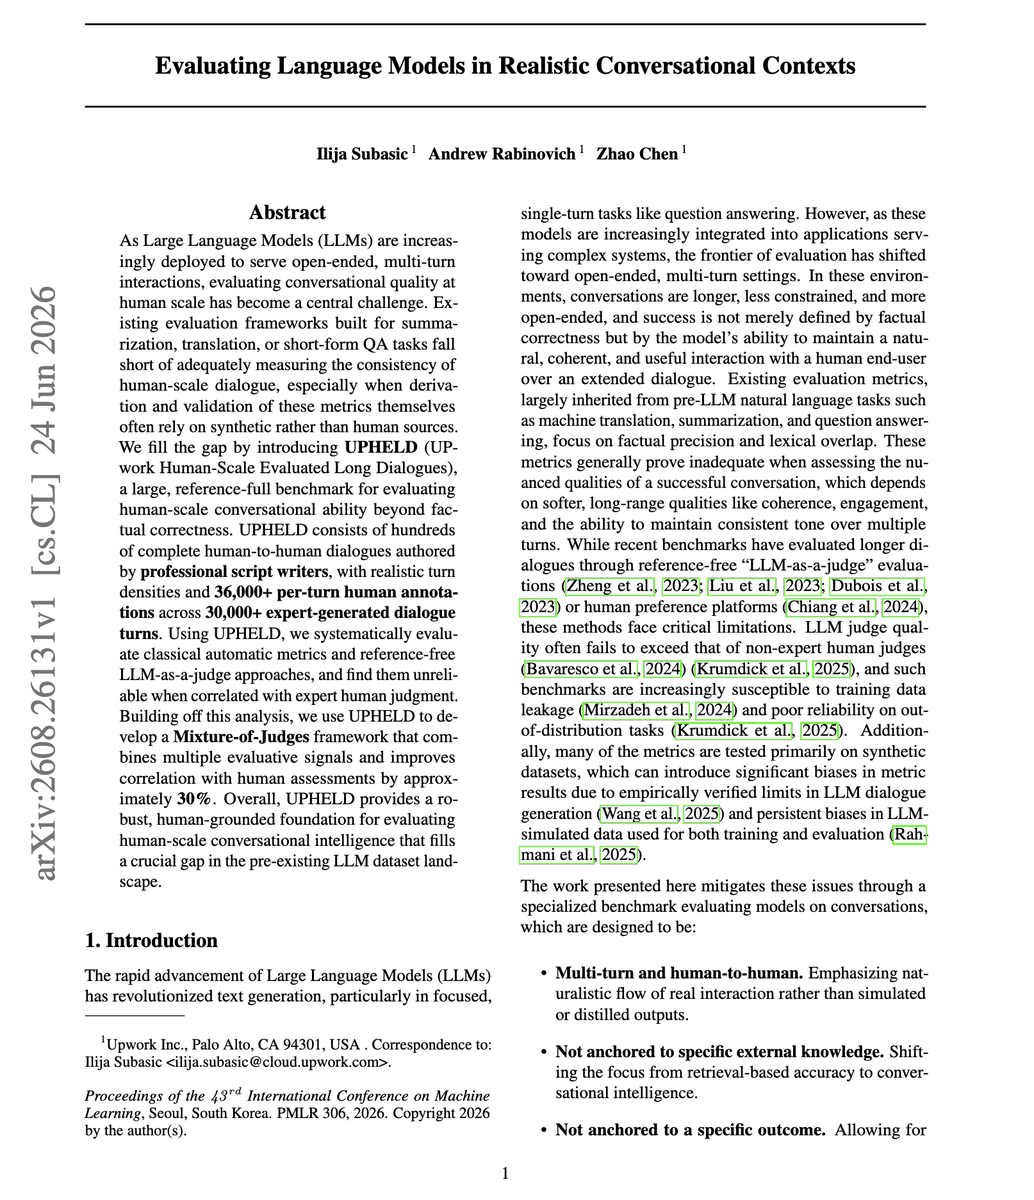
Yapay zeka alanında kritik bir araştırma, LLM judge sistemlerinin uzman insan değerlendirmeleriyle ciddi sapmalar gösterdiğini ortaya koydu. Araştırmaya göre, mevcut otomatik değerlendirme metrikleri ve referanssız LLM judge yaklaşımları güvenilir sonuçlar üretemiyor. DAIR.AI’nin paylaştığı bulgular, 30 binden fazla uzman tarafından üretilen diyalog ve 36 binden fazla inceleme üzerine kuruluyor.
LLM Judge Nedir ve Neden Önemli?
LLM judge, büyük dil modellerinin bir başka dil modelinin ürettiği cevapları değerlendirmek için kullandığı bir sistem. Geleneksel otomatik metriklerin yetersiz kaldığı durumlarda, bu yaklaşımların daha esnek ve insan benzeri değerlendirmeler sunacağı düşünülüyordu. Ancak yeni araştırma, bu varsayımı sorguluyor.
Araştırmacılar, 300’den fazla tam insan danışman tarafından yazılmış gerçekçi diyalog kullandı. Bu diyaloglar profesyonel senaristler tarafından hazırlandı ve gerçekçi konuşma yoğunluklarına sahip. Böylece sentetik veri yerine gerçek insan etkileşimlerine dayalı bir değerlendirme çerçevesi oluşturuldu.
Mevcut Değerlendirme Frameworklerinin Sınırları
Günümüzde kullanılan LLM judge sistemlerinin büyük çoğunluğu özetleme, çeviri ve kısa biçimli soru-cevap görevleri için tasarlandı. Uzun soluklu, çok dönüşlü konuşmaların değerlendirilmesinde bu sistemler yetersiz kalıyor. Araştırma, hem klasik otomatik metriklerin hem de referanssız LLM-as-a-judge yaklaşımlarının uzman hükümleriyle düşük korelasyon gösterdiğini ortaya koydu.
Mixture-of-Judges: %30 Daha İyi Korelasyon
Araştırmacılar, soruna Mixture-of-Judges çerçevesiyle yanıt verdi. Bu yaklaşım, birden fazla değerlendirme sinyalini birleştirerek insan değerlendirmesiyle yaklaşık yüzde 30 daha iyi korelasyon sağlıyor. Birden fazla model ve metriği melez bir şekilde kullanan sistem, tek başına LLM judge kullanımına kıyasla çok daha tutarlı sonuçlar üretiyor.
Neden Önemli?
AI haber sistemleri ve otomatik değerlendirme alanında çalışan geliştiriciler için bu bulgular kritik önem taşıyor. Tek bir LLM judge modeline güvenmek yerine, çoklu sinyal kullanımının daha güvenilir sonuçlar verdiği anlaşıldı. Bu durum, özellikle haber otomasyonu ve içerik değerlendirmesi yapan sistemler için yeni bir mimari yaklaşım gerektirebilir.
Araştırma detayları arxiv.org/abs/2608.26131 adresinde kamuya açık.
Kaynak: DAIR.AI / X, arxiv.org
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/llm-judge-uzman-degerlendirme/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın