
Kısaca · 3 madde
- 1LLM Judge Modelleri Uzman Değerlendirmesiyle Çelişiyor: Yeni Araştırma UPHELD Sonuçlarını Açıkladı
- 2Yapay zeka sistemlerini değerlendirmek için yaygın olarak kullanılan LLM judge modellerinin, gerçek uzman değerlendirmesiyle önemli ölçüde çeliştiği ortaya çıktı.
- 3LLM judge olarak da bilinen referanssız LLM-as-a-judge yaklaşımları, son yıllarda yapay zeka sistemlerini değerlendirmek için yaygın biçimde kullanılıyor.
LLM Judge Modelleri Uzman Değerlendirmesiyle Çelişiyor: Yeni Araştırma UPHELD Sonuçlarını Açıkladı
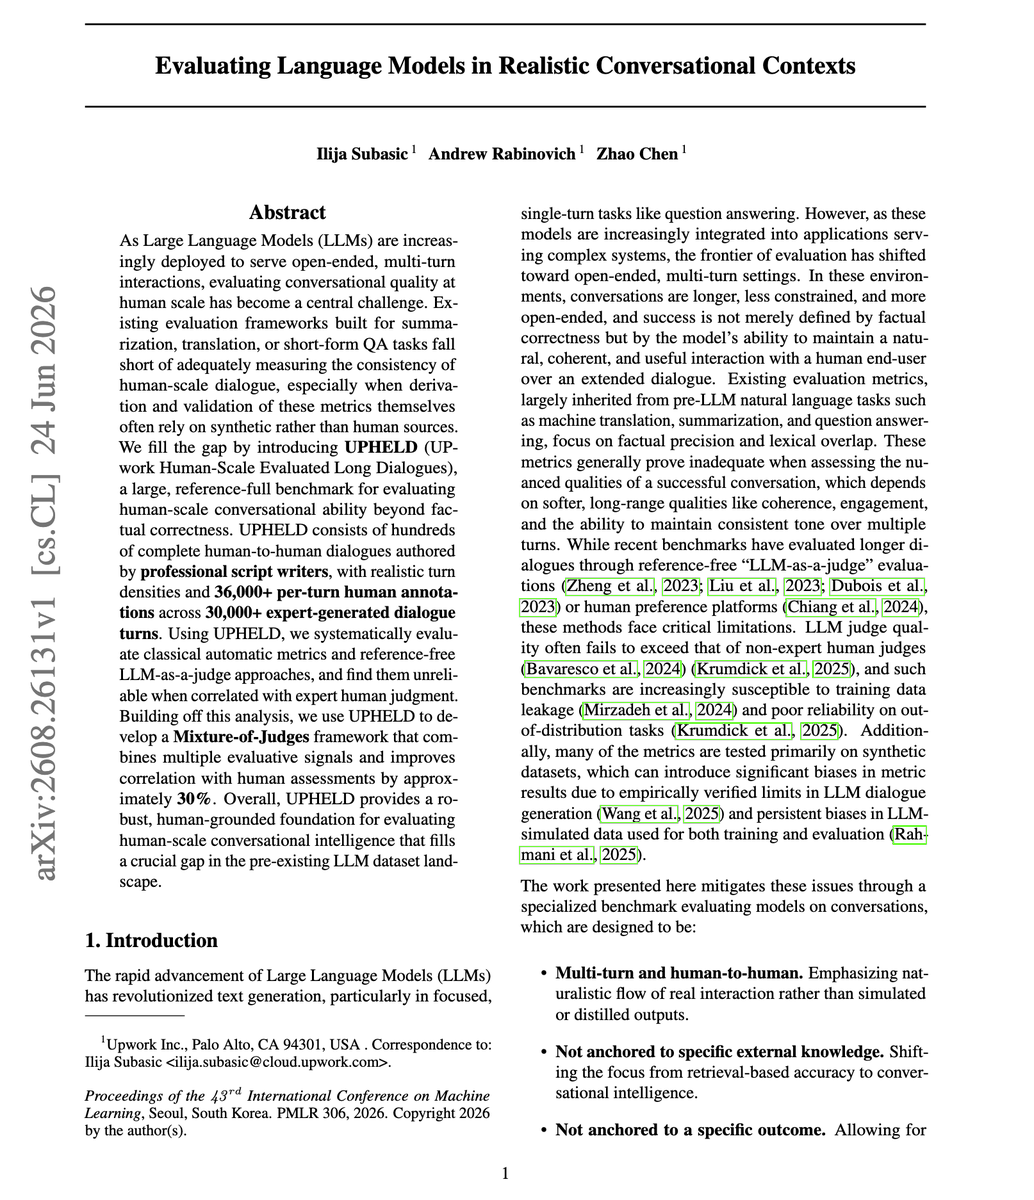
Yapay zeka sistemlerini değerlendirmek için yaygın olarak kullanılan LLM judge modellerinin, gerçek uzman değerlendirmesiyle önemli ölçüde çeliştiği ortaya çıktı. UPHELD (UPwork Human-Scale Evaluated Long Dialogues) benchmark araştırması, mevcut otomatik değerlendirme yöntemlerinin insan ölçeğindeki konuşma kalitesini ölçmede yetersiz kaldığını gösteriyor.
LLM Judge Modelleri Neden Güvenilir Değil?
LLM judge olarak da bilinen referanssız LLM-as-a-judge yaklaşımları, son yıllarda yapay zeka sistemlerini değerlendirmek için yaygın biçimde kullanılıyor. Ancak Evaluating Language Models in Realistic Conversational Contexts başlıklı yeni araştırmaya göre bu yöntemler, gerçekçi insan ölçeğindeki diyaloglarda uzman insan değerlendirmesiyle düşük korelasyon gösteriyor.
Araştırmacılar Ilija Subasic, Andrew Rabinovich ve Zhao Chen, mevcut değerlendirme çerçeelerinin özellikle şu görevler için tasarlandığını belirtiyor:
- Özetleme (summarization)
- Çeviri (translation)
- Kısa form soru-cevap (short-form QA)
Bu çerçeveler, açık uçlu ve çok turlu etkileşimlerdeki tutarlılığı ölçmede yetersiz kalıyor. Dahası, bu değerlendirme metriklerinin kendisi sentetik veriler üzerinde türetilmiş ve doğrulanmış durumda—gerçek insan diyaloğu verileriyle değil.
UPHELD Benchmark: 36 Bin Uzman Açıklaması
Araştırmacılar bu boşluğu doldurmak için UPHELD benchmark‘ını geliştirdi. UPHELD, yüzlerce tamamlanmış insan-haber diyaloğu içeren büyük ölçekli, referanslı bir değerlendirme veri seti. Profesyonel senarist yazarlar tarafından hazırlanan bu diyaloglar, gerçekçi tur yoğunlukları ve 30 binden fazla uzman tarafından oluşturulan 36 binden fazla tur başına insan açıklaması içeriyor.
UPHELD kullanılarak hem klasik otomatik metrikler hem de referanssız LLM-as-a-judge yaklaşımları sistematik olarak değerlendirildi. Sonuçlar, her iki yöntemin de uzman insan değerlendirmesiyle güvenilir biçimde korelasyon göstermediğini ortaya koydu.
Mixture-of-Judges: Yüzde 30 Daha İyi Korelasyon
Araştırmanın en önemli bulgusu, birden fazla değerlendirme sinyalini birleştiren Mixture-of-Judges çerçevesinin geliştirilmiş olması. Bu çerçeve, insan değerlendirmesiyle yaklaşık yüzde 30 daha iyi korelasyon sağlıyor.
Mixture-of-Judges yaklaşımı, tek bir LLM judge’a güvenmek yerine farklı değerlendirme sinyallerini birleştirerek daha dengeli ve güvenilir sonuçlar üretiyor. Bu yöntem, AI değerlendirme metodolojisinde önemli bir ilerlemeyi temsil ediyor.
Chat with Paper aracı üzerinden bu araştırmaya detaylı biçimde göz atılabiliyor.
AI Değerlendirmesinde Yeni Dönem
Bu bulgular, yapay zeka alanında değerlendirme metodolojilerinin yeniden düşünülmesi gerektiğini gösteriyor. Özellikle AI ajan sistemleri, çok turlu konuşma ve açık uçlu görevlerde değerlendirilirken, sentetik veriler yerine gerçek insan etkileşimlerine dayalı metrikler kullanılması kritik önem taşıyor.
UPHELD’in sunduğu bu insan temelli değerlendirme yaklaşımı, mevcut LLM veri seti manzarasındaki kritik bir boşluğu dolduruyor. Gelecekte AI sistemlerinin gerçek dünya performansını ölçmek için bu tür çok boyutlu, insan doğrulamalı benchmark’lara ihtiyaç duyulacak.
Kaynak: @dair_ai, X/Twitter | Araştırma: arxiv.org/abs/2608.26131
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/llm-judge-uzman-degerlendirmesi-upheld/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın