



Bağımsız değerlendirme kuruluşu METR, 20 Kasım 2026'da yeni bir yetenek ölçüm raporu yayımladı. METR zaman ufku ne demek? Kuruluş bu ölçüyü Mart 2025'te ilk yayımladığında en iyi model yaklaşık 1 saatlik ufka sahipti.
- Bağımsız değerlendirme kuruluşu METR, 20 Kasım 2026'da yeni bir yetenek ölçüm raporu yayımladı.
- METR zaman ufku ne demek?
- Kuruluş bu ölçüyü Mart 2025'te ilk yayımladığında en iyi model yaklaşık 1 saatlik ufka sahipti.
Bağımsız değerlendirme kuruluşu METR, 20 Kasım 2026'da yeni bir yetenek ölçüm raporu yayımladı.
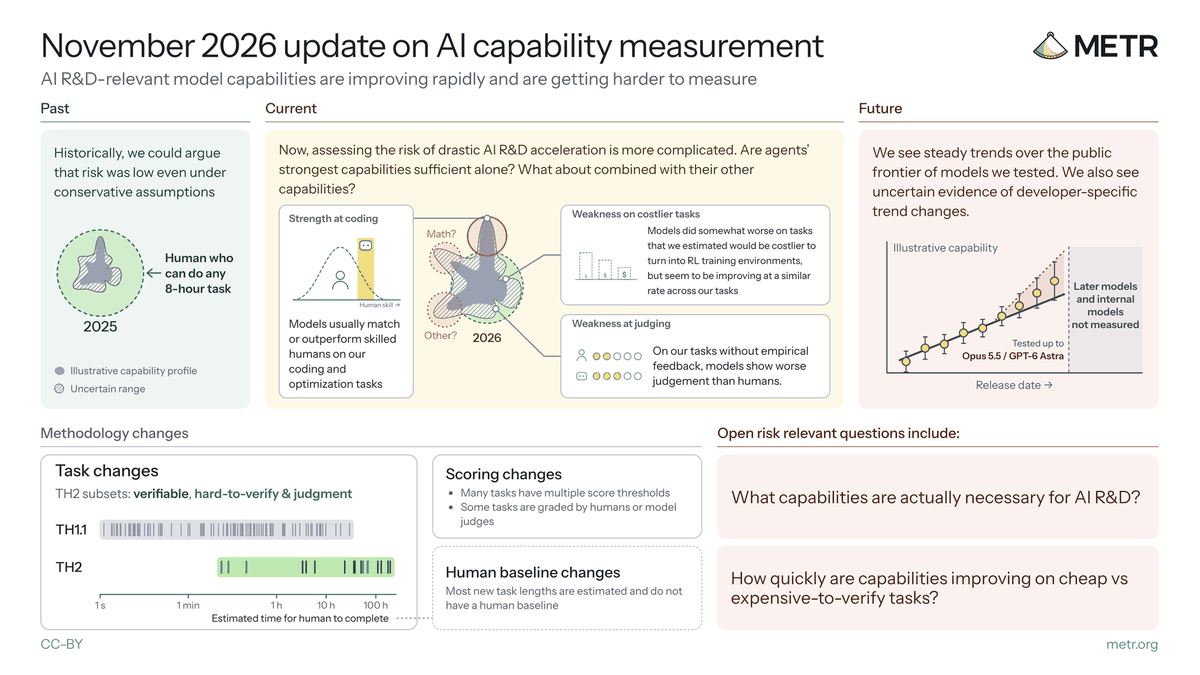
Bağımsız değerlendirme kuruluşu METR, 20 Kasım 2026’da yeni bir yetenek ölçüm raporu yayımladı. METR zaman ufku ölçümlerine göre yapay zekâ ajanlarının üstesinden gelebildiği görevlerin uzunluğu yaklaşık 3,6 ayda ikiye katlanıyor. Rapor, Opus 5.5 ve ’ya kadar olan kamuya açık modelleri kapsıyor. METR’in asıl uyarısı ise başka: Bu yetenekleri doğru ölçmek giderek zorlaşıyor.
METR zaman ufku ne demek?
METR, modelleri “zaman ufku” adlı bir ölçüyle değerlendiriyor. Bu ölçü şunu soruyor: Bir insan uzmanın kaç saatte yaptığı bir işi, model yüzde 50 başarıyla tamamlayabiliyor? Örneğin zaman ufku 10 saat olan bir model, insanın 10 saatte bitirdiği görevlerin yarısını başarıyor.
Kuruluş bu ölçüyü Mart 2025’te ilk yayımladığında en iyi model yaklaşık 1 saatlik ufka sahipti. Bu model Claude Sonnet 3.7’ydi. METR’e göre bir yıl içinde modeller, 30 saate kadar görevler içeren eski test setini doldurdu. Bu yüzden kuruluş TH2 adlı yeni ve daha zor bir set hazırladı.
Raporun öne çıkan bulguları
- İkiye katlanma süresi: Eski ve yeni test setleri birlikte ele alındığında zaman ufku yaklaşık 3,6 ayda ikiye katlanıyor.
- Daha hızlı bir işaret: Yeni setin otomatik puanlanabilen kısmında bu süre 1,65 aya iniyor. METR bu verinin gürültülü olduğunu ve başka açıklamaları da olabileceğini vurguluyor.
- 27 saatlik ufuk: Bugünün en iyi modelleri, yeni setin doğrulanabilir kısmında 27 saate kadar zaman ufkuna ulaşıyor.
- İnsanı geçen modeller: Kodlama ve optimizasyon görevlerinde modeller çoğunlukla yetenekli insanlara denk ya da onlardan iyi. METR, modelleri geçen insan test katılımcısı bulmakta çoğu zaman zorlandığını yazıyor.
- Zayıf karar verme: Net geri bildirim olmayan görevlerde modellerin muhakemesi insan uzmanlardan zayıf kalıyor.
METR’e göre bu ikiye katlanma hızı, ’ın iç araştırma görevleri için açıkladığı eğilime benziyor. O raporu OpenAI’ın ajanlar ve araştırma görevleri haberimizde anlatmıştık.
Ölçüm neden zorlaşıyor?
Raporun en önemli kısmı belki de bu. METR, kolay çalıştırılan test ortamlarının gerçek yeteneği olduğundan yüksek gösterebileceğinden endişe ediyor. Sebep şu: Şirketler modellerini, bu testlere çok benzeyen ortamlarda pekiştirmeli öğrenmeyle eğitiyor. Model bir sınavın benzerleriyle çalıştıysa, o sınavdaki başarısı genel yeteneği tam yansıtmayabilir.
METR bu yüzden test görevlerinin “yaşam döngüsü maliyeti” adını verdiği bir ölçü geliştirdi. Bu, bir testi hazırlamanın, çalıştırmanın ve puanlamanın ne kadar zahmetli olduğunu gösteriyor. Kuruluşun bulgusuna göre maliyetli görevler modellere daha zor geliyor. Yine de modeller hem ucuz hem pahalı görevlerde benzer hızla gelişiyor.
Yeni test setinde oyunlar da var. Minecraft’ı bitiren bir bot yazmak ya da Slay the Spire oynamak bunlardan bazıları. Bir görevde de modellerden METR için yeni bir değerlendirme görevi hazırlamaları isteniyor.
Asıl soru: Yapay zekâ araştırması hızlanabilir mi?
METR’in bu ölçümlerle cevap aradığı soru, yapay zekânın kendi gelişimini hızlandırıp hızlandıramayacağı. Kuruluş, eldeki kamu verilerinin önümüzdeki birkaç yılda “sert bir hızlanmayı” dışlamaya yetmediğini söylüyor. Sert hızlanmadan kastı, insanların yeni sistemlerin risklerini anlayıp tepki veremeyeceği kadar hızlı bir ilerleme.
Öte yandan METR, genel bir yetenek endeksiyle bakıldığında kamuya açık modellerde belirgin bir hızlanma ya da yavaşlama görmediğini de yazıyor. Bazı şirketlere özgü eğilim değişiklikleri görülse de bu bulgular yönteme çok duyarlı. Kuruluş, temel sorularda hâlâ ciddi belirsizlik olduğunu kabul ediyor.
Türkiye ve kullanıcılar için ne anlama geliyor?
Bu rapor, yapay zekâ haberlerini okurken işe yarayacak bir uyarı içeriyor. Şirketlerin açıkladığı test puanları her zaman gerçek dünyadaki başarıyı göstermiyor. METR gibi bağımsız kuruluşlar bile ölçümün zorlaştığını kabul ediyor.
Pratik açıdan şunlar söylenebilir:
- Kod yazan ajanlar hızla güçleniyor. Yazılım ekipleri, uzun ve iyi tanımlanmış görevleri ajanlara devretmeyi ciddi olarak düşünebilir.
- Karar gerektiren işlerde insan şart. Net ölçütü olmayan, yargı isteyen işlerde modeller hâlâ zayıf.
- Kendi testinizi yapın. Bir modeli işinize almadan önce kendi gerçek görevlerinizle deneyin. Genel test puanları yanıltıcı olabilir.
- Yapay zekâ ile değerlendirmeye dikkat. METR’e göre model tabanlı puanlayıcılar, kendileri kadar güçlü modellerin çıktısını olduğundan iyi görebiliyor.
METR’in önceki çalışmalarını, örneğin Anthropic’in risk raporunu incelediği yazıyı, sitemizde okuyabilirsiniz.
Kaynak: METR: AI R&D-relevant model capabilities are improving rapidly and are getting harder to measure; MIT Technology Review: The most misunderstood graph in AI just got a major update
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/metr-zaman-ufku-raporu-kasim-2026/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.
Yorum yazın