
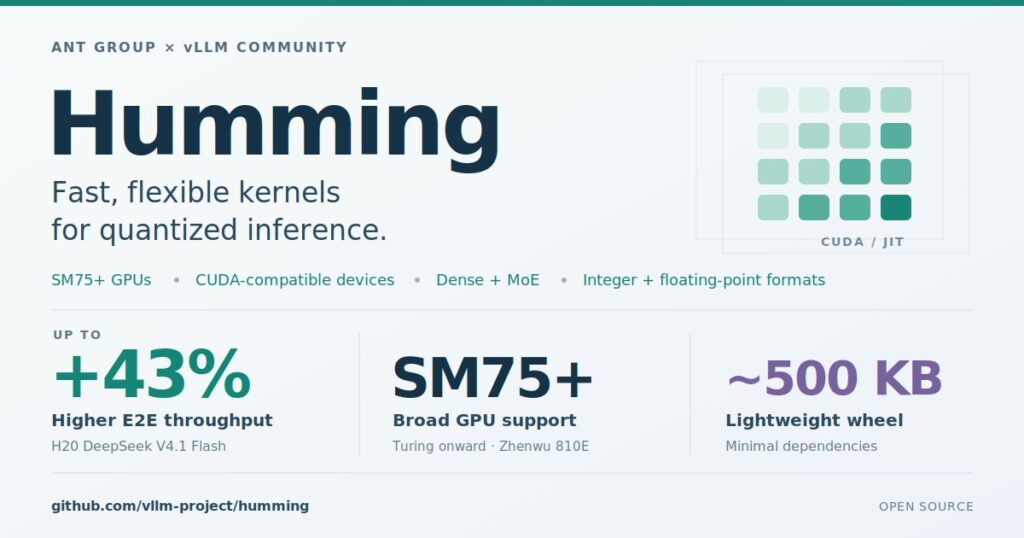
Çinli fintech devi Ant Group ile vLLM topluluğu, kuantize (düşük hassasiyetli) model çıkarımı için genel amaçlı ve yüksek performanslı bir çekirdek (kernel) kütüphanesi olan Humming‘i açık kaynak olarak yayımladı. Kod, github.com/vllm-project/humming deposunda bulunuyor.
Hangi sorunu çözüyor?
vLLM blogundaki duyuruya göre modeller büyüdükçe bellek kapasitesi, bellek bant genişliği ve hesaplama maliyeti dağıtımı giderek daha fazla kısıtlıyor; bu durum özellikle her token’ın yalnızca bazı uzmanları etkinleştirdiği ama tüm ağırlıkların saklanması gereken MoE modellerinde belirgin. Kuantizasyon bu yükü azaltıyor, ancak WNA16, W8A8, W4A8 ve W4A4 gibi çok sayıda yapılandırma ile INT4 ve NVFP4 gibi farklı sayı biçimleri, her kombinasyon için ayrı çekirdek geliştirip bakımını yapmayı zorlaştırıyor. Humming, kuantizasyon tanımlarını yürütme tercihlerinden ayırıp çekirdekleri ortak bileşenlerden derleyerek bu sorunu ele alıyor.
Mimari
- Birleşik kuantizasyon gösterimi: Farklı kuantizasyon araçlarından çıkan modeller, ağırlıkları, ölçekleri ve sıfır noktalarını tutarlı biçimde düzenleyen “Humming standart formatına” dönüştürülüyor.
- Üç yapılandırma: Layer Config (tensör şekilleri, veri tipleri, hedef mimari), Compute Config (GEMM tipi ve hesaplama seçenekleri) ve Tuning Config (karo şekilleri, boru hattı aşamaları, warp uzmanlaşması, MMA komutları) çekirdeği tanımlıyor. Varsayılan ayarlar cihaza özgü sezgisel kurallarla seçiliyor.
- Hızlı JIT derleme: Çekirdekler NVRTC veya NVCC ile derleniyor ve önbelleğe alınıyor. H200 sunucuda CUDA 13.4 ile yapılan tek bir W4A16 çekirdek derleme testinde süre, CUTLASS + NVCC’deki 23,35 saniyeden Humming ile NVCC’de 1,82, NVRTC’de 1,88 saniyeye indi. Tek bir katmanın tüm desteklenen M boyutlarını kapsayan çekirdekleri derleyip yüklemek yaklaşık 2–4 saniye sürüyor.
Donanım ve format desteği
Humming, NVIDIA tarafında Turing’den itibaren tüm mimarileri tam olarak destekliyor. CUDA uyumlu diğer cihazlara genişletilebilen yapı sayesinde Alibaba’nın çip birimi T-Head’in Zhenwu 810E hızlandırıcısı da tam destekleniyor. Blackwell öncesi GPU’larda yerel MXFP4 desteği olmamasına karşın, Humming çekirdek içinde MXFP4’ü INT8/FP8’e dönüştüren hızlı bir yol sunarak H200 gibi GPU’larda yüksek performanslı W4A8-MXFP4 çalıştırmayı mümkün kılıyor. Kütüphane, topluluğun Blackwell Tensor Core’larında keşfettiği ve PTX tip sisteminde açığa çıkarılmayan float4e0m3 ve float8e3m4 biçimlerini de tüm Blackwell mimarilerinde destekliyor; Rubin bu iki biçimi desteklemediği için bu yollar Rubin’e uzanmıyor.
Performans
vLLM topluluğunun çalıştırdığı mikro benchmark’lara göre yoğun (dense) W4A16’da Humming test edilen yapılandırmaların çoğunda vLLM Marlin’i yakalıyor veya geçiyor. cuBLAS temel alındığında küçük batch boyutlarında birçok cihazda yaklaşık 3–4 kat hızlanma sağlanıyor; büyük batch’li H200 iş yüklerinde Marlin’in yaklaşık iki katına, bazı B300 durumlarında üç katından fazlasına ulaşılıyor. MoE tarafında H20 ve H200’de MXFP4 W4A16 birçok orta-büyük batch senaryosunda Marlin’in yaklaşık iki katı performans gösterirken, B300’de MXINT4 ve NVFP4 yollarında Grouped yol büyük batch’lerde yaklaşık 5 kata çıkıyor. SM120 ve SM121 cihazlarında da Humming’in Marlin ve ilgili FlashInfer uygulamalarını geride bıraktığı belirtiliyor.
Kaynak: vLLM Blog: Announcing Humming: Fast, Flexible Kernels for Quantized Inference · GitHub: vllm-project/humming
Henüz yorum yok. İlk yorumu siz yapın!