
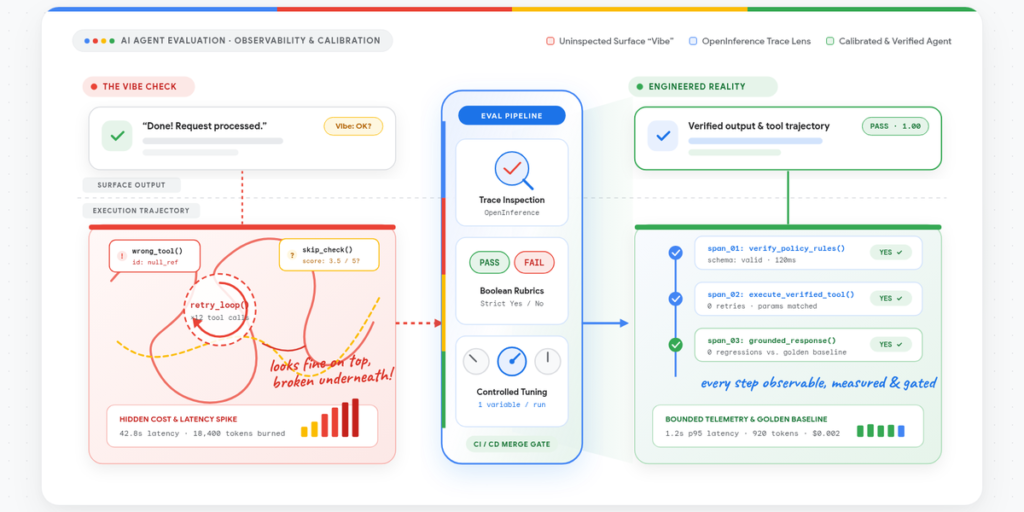
Google Developers Blog (15 Ekim 2026), “How to Actually Evaluate (Any) AI Agent: Beyond the Vibe Check” klinik bölümünün oyun kitabını yayımladı. Mesaj: üç-dört promptu gözle kontrol etmek, döngüye giren, token yakan veya araç çağrılarını yanlış yapan ama kibar yanıt dönen ajanları yakalamaz.
Önerilen çerçeve
Yazarlar başarıyı kritik kullanıcı yolculukları (CUJ) ile tanımlamayı; başlangıçta ADK kullanıcı simülasyonlarıyla sentetik senaryolar üretmeyi; birim testleri, deterministik metrikler, LLM-as-a-judge rubrikleri ve entegrasyon testlerini katmanlamayı öneriyor. 1–5 puanlı bulanık yargıç skorları yerine mümkün olduğunca boolean (geçti/kaldı) sorular; gecikme, token, API maliyeti ve araç çağrı sayısının cevap kalitesiyle birlikte ölçülmesi; OpenTelemetry izlerinin OpenInference sözdiziminde standartlaştırılması vurgulanıyor. Açık kaynak agent-eval araç seti ve Gemini platformundaki Agent Evaluation servisi Day 0–2 yol haritasında anılıyor; CI’de genel geçme eşiği ve çekirdek metriklerde sıfır gerileme kapıları örnekleniyor.
Kaynak: Google Developers Blog: Evaluating AI agents: moving past the vibe check
Henüz yorum yok. İlk yorumu siz yapın!