
Kısaca · 3 madde
- 1Microsoft Research, Çok Dilli Yapay Zeka Ajanlarında Politika Tutarlılığını Ölçtü
- 2Microsoft Research, yapay zeka ajanlarının farklı dillerde nasıl performans gösterdiğini ortaya koyan kapsamlı bir çalışma yayımladı.
- 3Microsoft Research araştırmacıları Sourabrata Mukherjee, Kalika Bali ve Sunayana Sitaram tarafından yürütülen çalışmada, klasik değerlendirm…
Microsoft Research, Çok Dilli Yapay Zeka Ajanlarında Politika Tutarlılığını Ölçtü
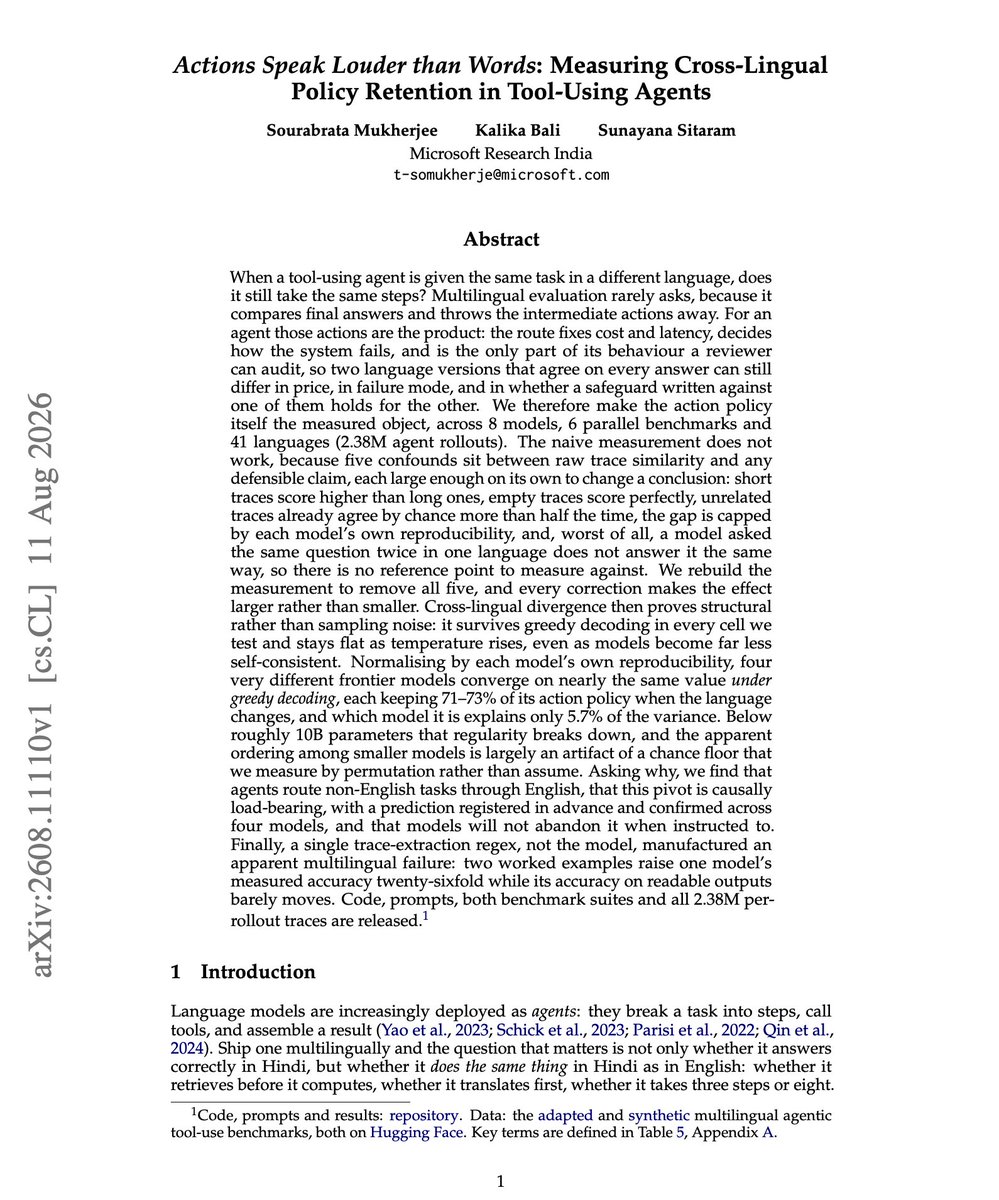
Research, yapay zeka ajanlarının farklı dillerde nasıl performans gösterdiğini ortaya koyan kapsamlı bir çalışma yayımladı. “Actions Speak Louder than Words” başlıklı araştırma, 8 farklı modelin 41 dilde 2,38 milyon deneme yapılarak incelenmesini içeriyor. Çalışmanın temel bulgusu: Frontier yapay zeka modelleri, diller arasında yüzde 71-73 oranında eylem politika tutarlılığı koruyor.
Araştırmanın Kapsamı ve Metodolojisi
Research araştırmacıları Sourabrata Mukherjee, Kalika Bali ve Sunayana Sitaram tarafından yürütülen çalışmada, klasik değerlendirme yöntemlerinden farklı bir yaklaşım benimsendi. Geleneksel testlerin aksine bu araştırma, ajanların yalnızca son yanıtlarını değil, tüm eylem dökümlerini (trajectory) inceledi. Eylem dökümleri; maliyet, gecikme, hata modu ve denetlenebilirlik gibi kritik faktörleri de içeriyor.
Araştırma kapsamında 6 paralel kıyaslama testi kullanıldı. Değerlendirmeye alınan 8 model, 41 farklı dilde toplam 2,38 milyon deneme gerçekleştirdi. Bu hacim, alanında şimdiye kadar yapılmış en geniş çaplı çok dilli ajan değerlendirmesi olarak öne çıkıyor.
İngilizcenin “Yapısal Köprü” Rolü
Çalışmanın en dikkat çekici bulgularından biri, İngilizcenin çok dilli yapay zeka ajanlarında üstlendiği rol oldu. Araştırmacılar, ajanların İngilizce dışındaki dillerdeki görevleri İngilizce üzerinden yönlendirme eğiliminde olduğunu tespit etti. Bu durum, İngilizcenin “yapısal köprü” olarak işlev gördüğünü ortaya koyuyor.
Bu mekanizma, frontier modellerin çok dilli ortamlarda tutarlı performans göstermesinin ardındaki temel nedenlerden biri olarak değerlendiriliyor. Ancak bu aynı zamanda, İngilizce dışındaki dillerdeki işleme kapasitesinin doğrudan ölçülmesini de zorlaştırıyor.
Küçük Modellerde Kritik Başarısızlık
Araştırma, parametre sayısı 10 milyarın altında kalan modellerin çok dilli ortamlarda ciddi performans düşüşü yaşadığını ortaya koydu. Küçük ölçekli modellerin dil performansı, rastgele seçim düzeyine kadar geriliyor. Bu bulgu, küçük dil modellerinin üretim ortamlarında çok dilli görevlerde güvenilir şekilde kullanılamayacağını gösteriyor.
Değerlendirme Hatası ve 26 Katlık İyileşme
Araştırma ekibi, değerlendirme sürecinde yapılan bir regex hatasının tek bir modelin doğruluğunu 26 kat artırdığını belgeledi. Bu durum, değerlendirme metodolojisindeki hataların sonuçları dramatik şekilde etkileyebileceğini gözler önüne seriyor. Eylem dökümlerinin sistematik incelenmesinin önemi bir kez daha vurgulanıyor.
Research, bu çalışmayla yapay zeka ajanlarının gerçek dünya performansını ölçmede yeni bir kıyaslama noktası belirliyor. Politika tutarlılığının korunması, özellikle uluslararası ve çok dilli uygulamalarda kritik önem taşıyor.
Çalışmanın tamamına arXiv’den ulaşılabilir.
Kaynak: @dair_ai (X)
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/microsoft-research-cok-dilli-ajan-tutarlilik/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın