
Kısaca · 2 madde
- 1Microsoft Research, yapay zeka model eğitiminde onemli bir kesif yapti.
- 2Araştırma, arXiv'de yayimlanan calismanin tamamina erisilebilir durumda.
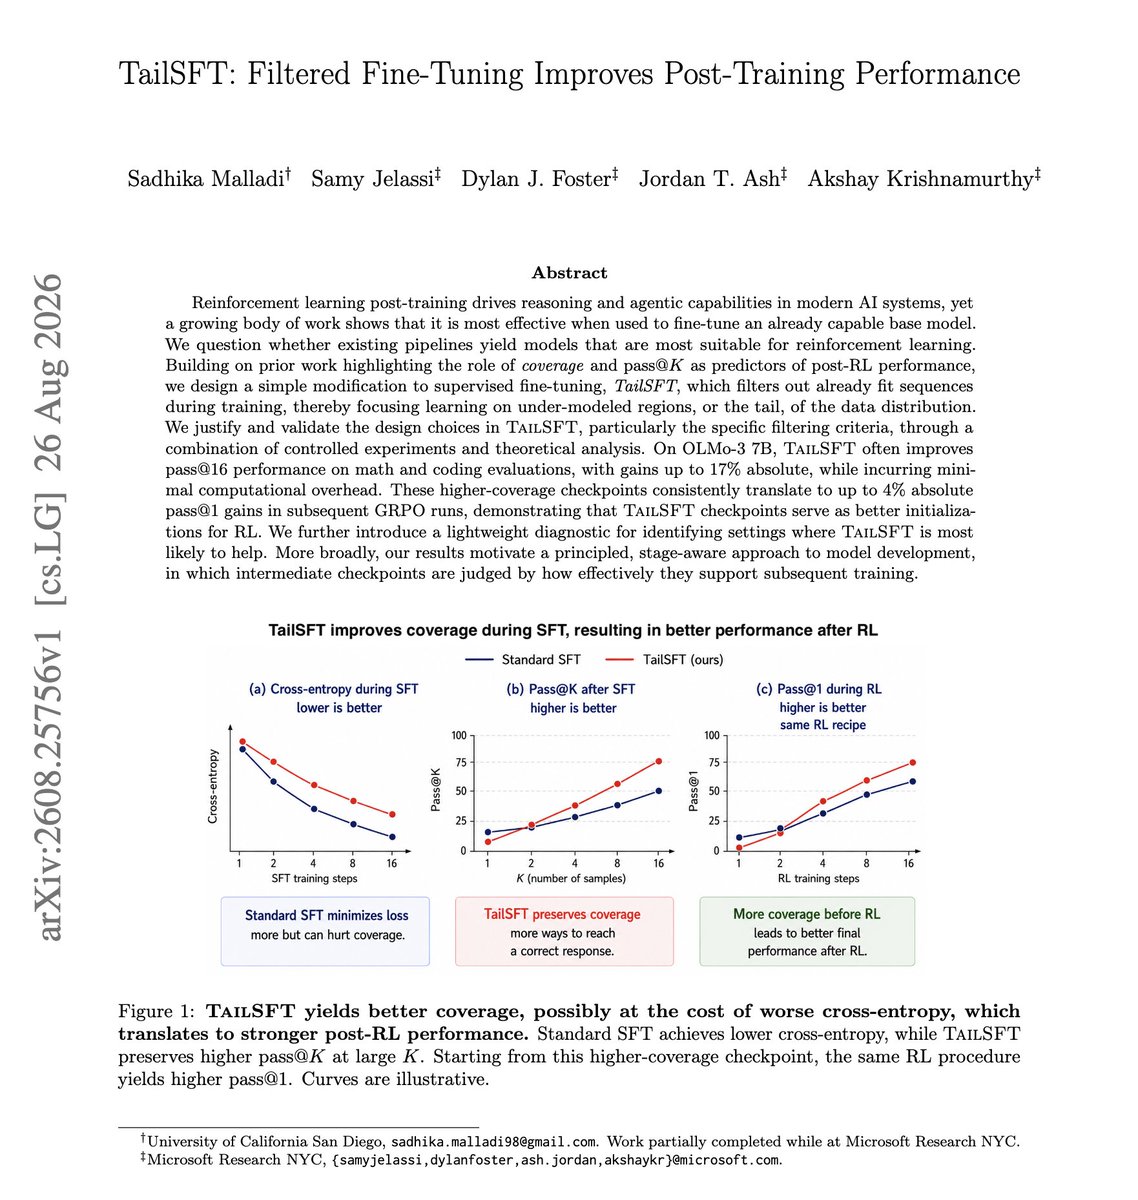
Research, yapay zeka model eğitiminde onemli bir kesif yapti. Standart Supervised Fine-Tuning (SFT) yonteminin, sinir aglarının zaten ogrendigi dizilere gereksiz yere gradient harcadigini ve bunun model performansini sinirlandirdigini ortaya cikardi. TailSFT (Filtered Fine-Tuning) adi verilen yeni yontem ise bu sorunu kokten cozuyor.
Standart SFT’nin Gizli Sorunu
Geleneksel supervised fine-tuning, modeli eğitirken tum veri dizilerine esit sekilde yaklasiyor. Ancak model zaten belirli dizileri ogrenmis oldugunda, bu dizilere ayrılan gradient guncellemeleri modelin yeni ve zor verilere odaklanma kapasitesini kisitliyor. Research ekibi, standart SFT’nin orijinal modelden devralinan onceden ogrenmis bilgiler uzerine gereksiz yere gradient harcamaya devam ettigini fark etti.
TailSFT Nasil Calisiyor?
TailSFT (Filtered Fine-Tuning), bu sorunu elegane bir sekilde cozmeyi basariyor. Yontem, modelin zaten iyi ogrendigi dizileri eğitim suresince filtrediyor ve ogrenmenin daha az model uzerinde yogunlastigi ‘kuyruk’ bolumlerine odaklaniyor. Bu degisiklik, minimal bilgisalayarlama yuku ile birlikte geliyor ancak modelin genel performansini onemli olcude artiriyor.
Teknik Sonuclar: OLMo-3 7B Uzerinde Test
- Kodlama basarisinda: pass@16 metriginde 16.8 puan mutlak iyilesme
- Matematik performansinda: pass@16’da 3.1 puan mutlak iyilesme
- GRPO sonrasi: Final pass@1’de 3.9 puan mutlak iyilesme
- Bazi ayarlarda: Erken donem odul 2.5 kat daha hizli yukseldi
Evre-Bilincli AI Gelistirme Yaklasimi
Araştırmacılar, bulgularinin ‘evre-bilincli’ (stage-aware) bir AI gelistirme yaklasimini destekledigini vurguluyor. Buna gore, aradaki eğitim kontrolnoktalarinin degeri, bir sonraki eğitim evresini ne kadar iyi destekledikleriyle olculmeli. TailSFT’nin en onemli katkılarından biri, reinforcement learning (RL) ile SFT arasındaki iliskiyi yeniden dusunmemizi saglamasi.
Araştırma, arXiv’de yayimlanan calismanin tamamina erisilebilir durumda.
Kaynak: DAIR.AI (@dair_ai) / X
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/microsoft-tailsft-supervised-fine-tuning-arastirmasi-2/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın