
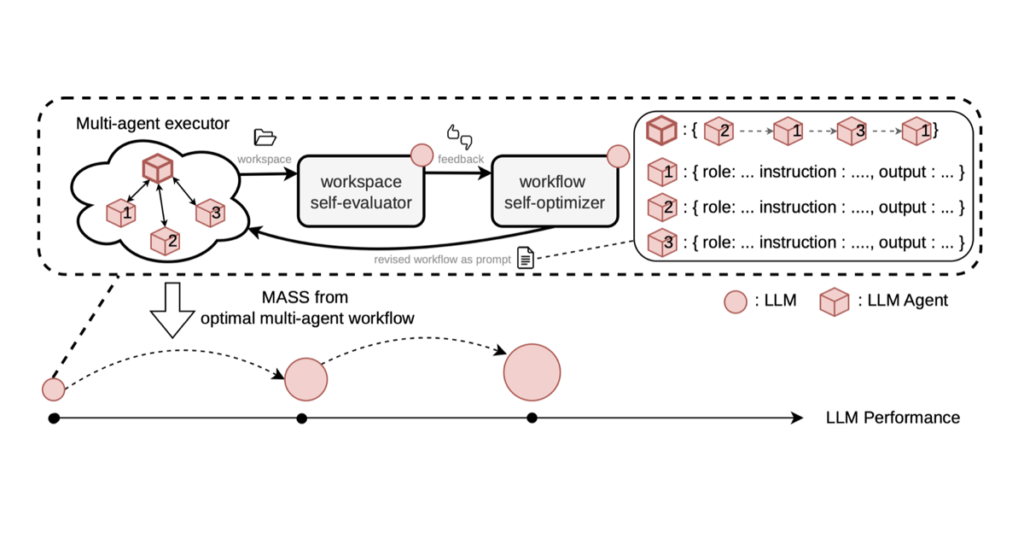
Japon yapay zekâ şirketi Sakana AI, UC Berkeley’den araştırmacılarla birlikte hazırladığı “Recursive Self-Improvement through Multi-Agent Self-Supervision” başlıklı makaleyi 12 Ekim 2026’da duyurdu. Çalışmada tanıtılan MASS (Multi-Agent Self-Supervision), bir modelin kendi “ekibinin” kolektif zekâsından öğrenerek kendini geliştirip geliştiremeyeceği sorusuna yanıt arıyor. Makale arXiv’de, kod ise GitHub’da yayımlandı.
Çıkış noktası: Değerlendirici de modelin kendisi olunca
Sakana AI’a göre yapay zekâ sistemleri giderek daha açık uçlu araştırma problemlerine yöneldikçe insan uzmanların sonuçları değerlendirip ilerlemeye yön vermesi zorlaşabilir; bu noktada en yetenekli denetçi modelin kendisi olabilir. Araştırmacılar bu durumu, iyileştirilen modelin aynı zamanda kendi optimize edicisi ve değerlendiricisi olduğu “homojen özyinelemeli kendini geliştirme” (RSI) olarak tanımlıyor. Temel zorluk, modelin kendi kör noktalarını düzeltmek yerine pekiştirme riskine karşın bu döngüde işe yarar bir öz denetim sinyali elde etmek.
MASS nasıl çalışıyor?
MASS’ta tek bir model, sanal alt ajanlardan oluşan bir ekip aracılığıyla görevleri çözüyor. İç döngüde model ağırlıkları sabitken, ekibin rollerini, talimatlarını, ajanların teslim etmesi gereken çıktıları tanımlayan “sözleşmeleri” ve çağrı sırasını içeren iş akışı aranıyor; değerlendirici rolündeki model, yeni adayın çıktısını o ana kadarki en iyi iş akışınınkiyle karşılaştırıyor. Dış döngüde en iyi iş akışı her görev için 18 kez çalıştırılıyor, model sonuçları kendisi sıralıyor ve en iyi yürütmeler LoRA ile ince ayar verisi olarak kullanılıyor. Eğitim örneklerinden iş akışı metni çıkarılarak modelin işi görevin kendisinden organize etmeyi öğrenmesi hedefleniyor.
Sonuçlar
Ekip, açık ağırlıklı Qwen3.6-27B modeliyle finans, robotik ve eczacılık alanlarında kod, nicel sonuç ve araştırma raporu gerektiren sentetik araştırma görevleri üzerinde iki tam MASS turu çalıştırdı. İlerleme, MASS’tan gizli tutulan GPT-5.5 ve Claude Opus 4.8 hakemleriyle dışarıdan ölçüldü. Eğitimde kullanılmayan test görevlerinde temel modele karşı kazanma oranı birinci turdan sonra yüzde 53,9, ikinci turdan sonra yüzde 69,9 oldu. Kamuya açık MLR-Bench, DSBench, ScienceAgentBench ve AstaBench’te çıktı token’ı başına puan temel modelin 1,2–1,6 katına ulaştı. Ancak aktarım dengesiz kaldı: Terminal-Bench 2.0’da bu oran 0,96, SWE-bench Verified’da 0,94 kat oldu.
Sakana AI üç temel bulguyu öne çıkarıyor: Yalnızca görev çözme verisiyle eğitmek, optimize edici ve değerlendirici rollerini de geliştiriyor; çoklu ajan yürütmeleri, tekil ajan yürütmelerine göre RSI için daha verimli eğitim verisi sağlıyor; ve iyileşme hızında darboğaz değerlendiriciden çok optimize edici kapasitesi olabiliyor. Modelin değerlendirici rolündeki yargılarının dış hakemlerle uyumu yüzde 73’ten yüzde 93’e çıktı.
Güvenlik uyarısı
Şirket, homojen RSI’ın yapay zekâ güvenliği açısından dikkatle incelenmesi gerektiğini vurguluyor: Bir model aynı zamanda kendi değerlendiricisi olduğunda, ortak kör noktalar hataların ilerleme olarak kabul edilip eğitimle pekişmesine yol açabilir. Sakana AI’a göre yapay zekânın insan uzmanlığının ötesine güvenle geçebilmesi için bu başarısızlıkların anlaşılması ve tespit edip müdahale etmenin etkili yollarının korunması gerekiyor. Çalışma Hyunin Lee, Jinglue Xu, Jeffrey Seely ve Yujin Tang ile UC Berkeley’den Somayeh Sojoudi, Matei Zaharia ve Donghyun Lee tarafından yapıldı.
Kaynak: Sakana AI: Recursive Self-Improvement through Collective Intelligence · Sakana AI MASS ayrıntılı blog · arXiv makalesi · GitHub: SakanaAI/mass
Henüz yorum yok. İlk yorumu siz yapın!