
Kısaca · 3 madde
- 1Stanford Üniversitesi araştırmacıları, büyük dil modellerinin güvenlik hizalaması sorununa köklü bir çözüm getiren yeni bir yöntem geliştirdi.
- 2Güvenlik Hizalaması Neden Utility Kaybına Yol Açıyor?
- 3CLEAR Yöntemi Nasıl Çalışıyor?
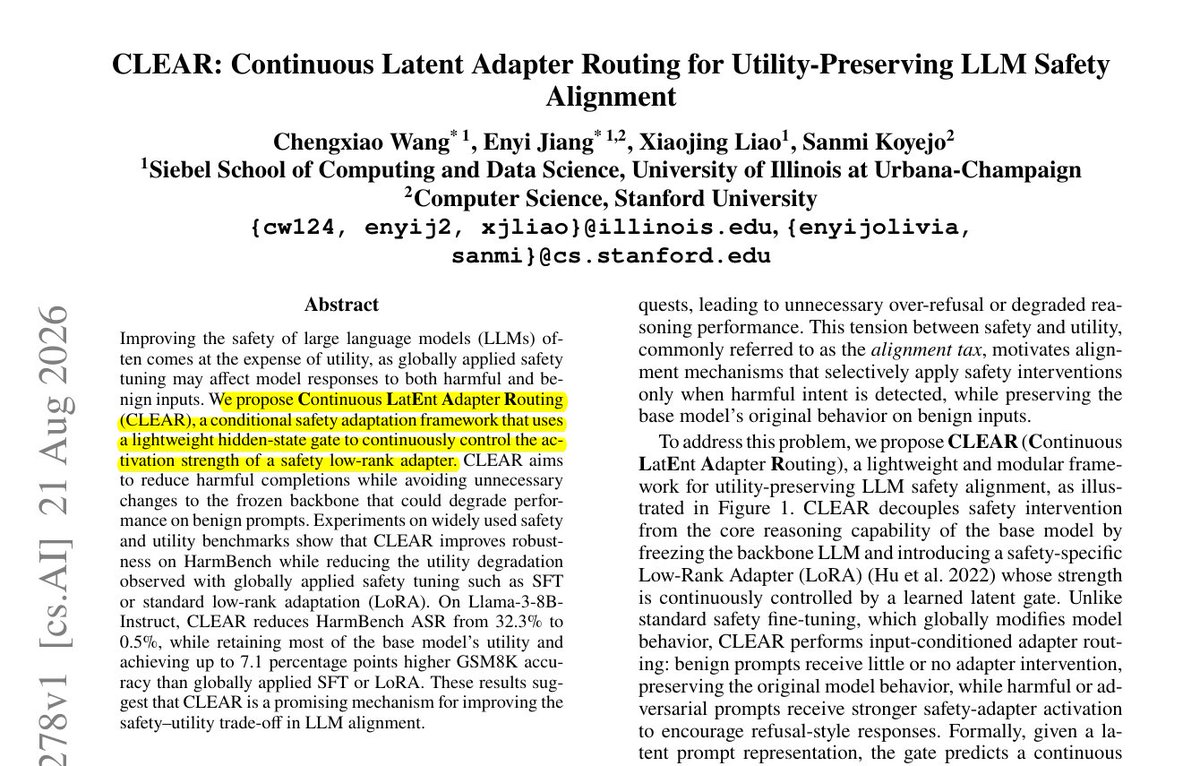
Stanford Üniversitesi araştırmacıları, büyük dil modellerinin güvenlik hizalaması sorununa köklü bir çözüm getiren yeni bir yöntem geliştirdi. CLEAR (Continuous Latent Adapter Routing) adı verilen bu çerçeve, güvenlik iyileştirmelerinin utility kaybına yol açmadan nasıl uygulanabileceğini gösteriyor.
Güvenlik Hizalaması Neden Utility Kaybına Yol Açıyor?
Geleneksel LLM güvenlik hizalaması yöntemleri, modelin ağırlıklarını doğrudan değiştirir. Bu yaklaşımda güvenlik ince ayarı (safety fine-tune), zararlı olsun ya da olmasın her girdiye uygulanır. Sonuç olarak model, zararsız promptlarda bile daha zayıf performans göstermeye başlar. Stanford araştırmacıları bu sorunu “her girdi artık daha güvenli ama daha zayıf bir model üzerinden çalışıyor” şeklinde tanımlıyor.
CLEAR Yöntemi Nasıl Çalışıyor?
CLEAR, orijinal modeli dondurulmuş bırakarak farklı bir strateji benimsiyor:
- Gizli Durum Geçidi (Hidden-State Gate): Her girdi için hafif bir kapı mekanizması, ne kadar güvenlik modülünün devreye gireceğini belirler.
- Koşullu Adaptasyon: Zararsız promptlar neredeyse hiç güvenlik modülü kullanmaz ve orijinal model üzerinde çalışır.
- Dondurulmuş Ana Model: Temel model değişmeden kalır, böylece genel yetenekler korunur.
- Güvenlik Low-Rank Adaptörü: Ayrı bir adaptör, yalnızca gerektiğinde devreye girer.
Etkileyici Sonuçlar: HarmBench ASR Yüzde 0.5’e Düştü
Araştırmacılar, CLEAR’ı Llama-3-8B-Instruct modeli üzerinde test etti. Sonuçlar çarpıcıydı:
- HarmBench Saldırı Başarı Oranı (ASR): Yüzde 32.3’ten yüzde 0.5’e düştü
- GSM8K Matematik Benchmark: SFT veya standart LoRA’ya kıyasla 7.1 puan daha yüksek doğruluk oranı
- Zararsız Prompt Performansı: Temel modelin utility’si büyük ölçüde korundu
Araştırma Detayları
Kağıt, Chengxiao Wang, Enyi Jiang, Xiaojing Liao ve Sanmi Koyejo tarafından kaleme alındı. Çalışma, yaygın kullanılan güvenlik ve utility benchmarkları üzerinde kapsamlı deneyler gerçekleştirdi.
Sonuç ve Değerlendirme
Bu çalışma, yapay zeka güvenliği alanında önemli bir kilometre taşı niteliği taşıyor. Güvenlik ve fayda arasındaki dengeyi koruyarak her ikisini de en üst düzeyde tutmak, LLM üreticileri için kritik bir hedeftir. CLEAR’ın önerdiği koşullu yaklaşım, gelecekteki güvenlik hizalaması yöntemlerine ışık tutuyor.
Kaynak: arxiv.org/abs/2608.21278
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/stanford-clear-llm-guvenlik-hizalamasi/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın