
Kısaca · 3 madde
- 1TailSFT Microsoft Araştırması: Standart SFT Boru Hattı Neden Yetersiz Kalıyor?
- 2Microsoft araştırmacıları, standart supervised fine-tuning (SFT) ardışık düzeninin pekiştirmeli öğrenme (RL) için gerçekten istenen modeli üretip üretmediğini inceledi.
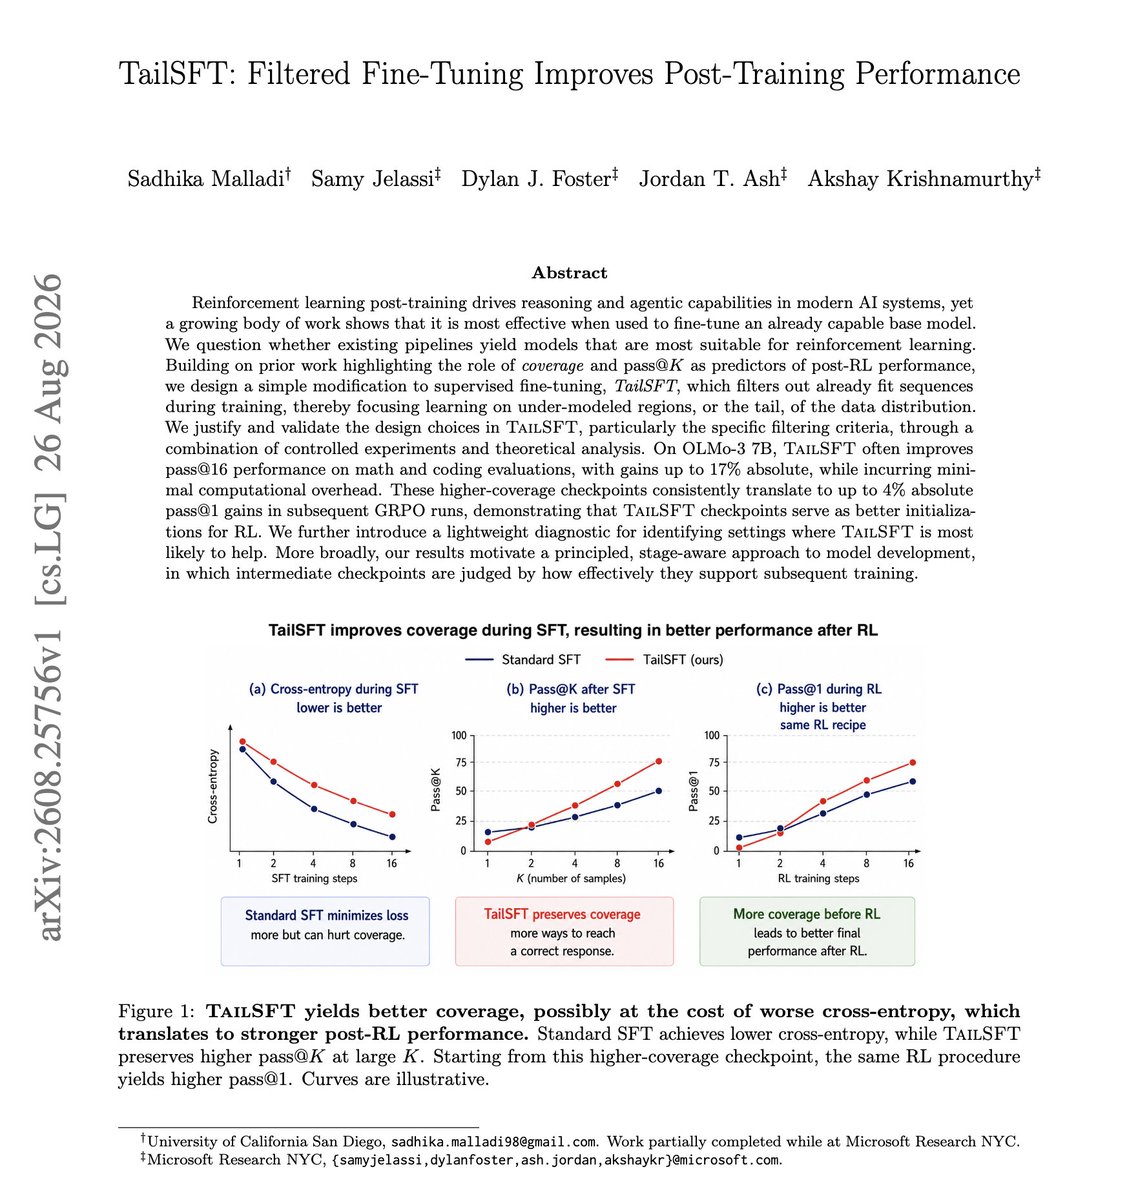
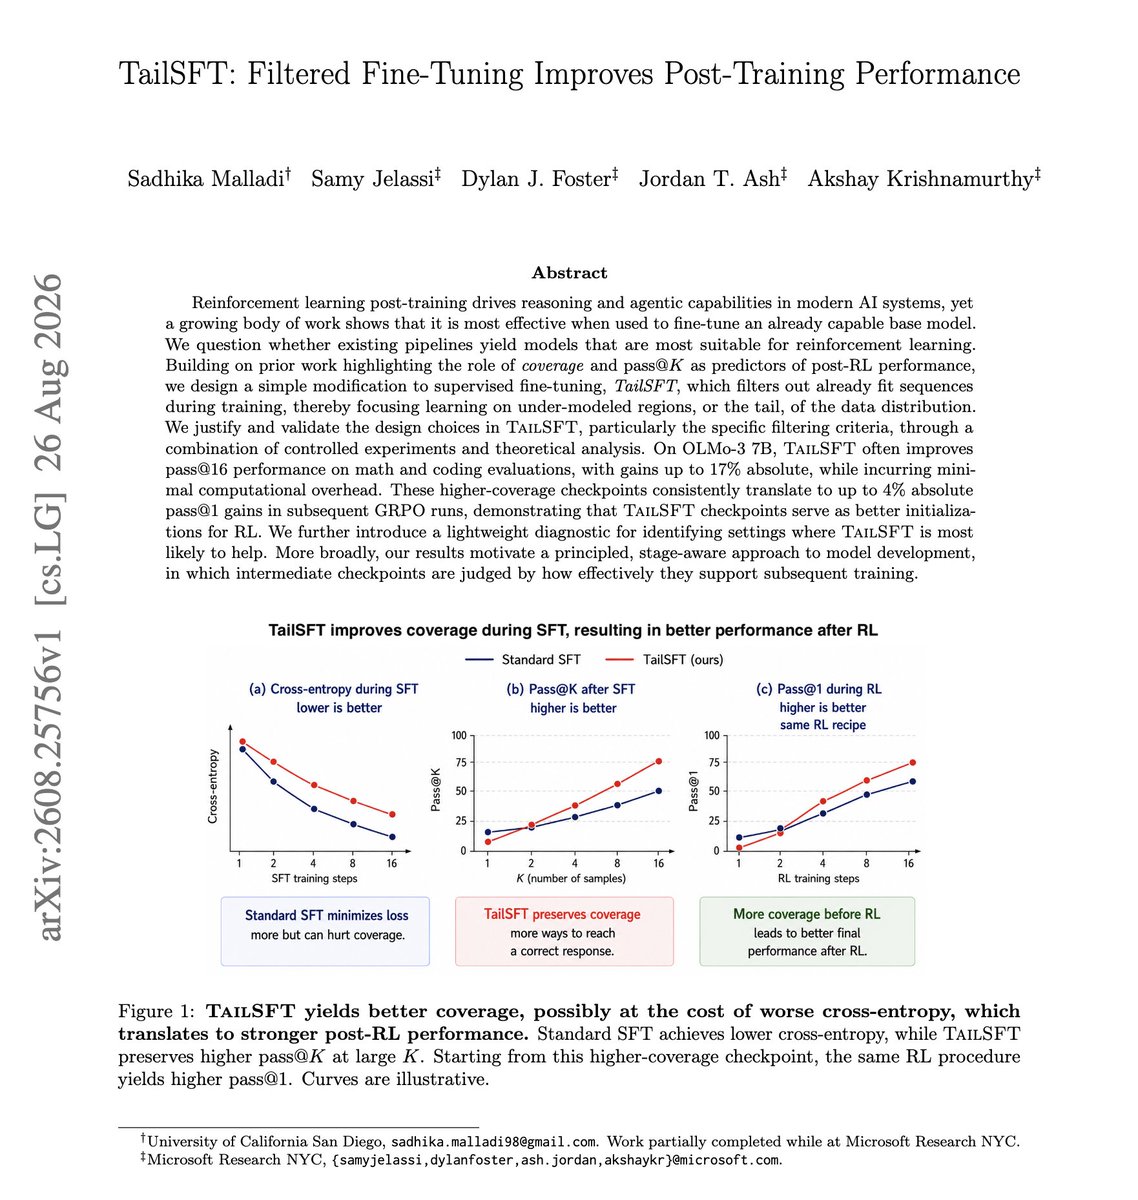
- 3Araştırmaya göre standart SFT, modelin zaten öğrendiği dizilere sürekli gradyan harcamaya devam ediyor.
TailSFT Microsoft Araştırması: Standart SFT Boru Hattı Neden Yetersiz Kalıyor?
araştırmacıları, standart supervised fine-tuning (SFT) ardışık düzeninin pekiştirmeli öğrenme (RL) için gerçekten istenen modeli üretip üretmediğini inceledi. Sonuç: Hayır. TailSFT araştırması, yapay zeka eğitim süreçlerinde kritik bir açığı ortaya koyuyor.
Standart SFT’nin Temel Sorunu
Araştırmaya göre standart SFT, modelin zaten öğrendiği dizilere sürekli gradyan harcamaya devam ediyor. Bu durum, RL’nin sonradan keşfetmesi gereken dağılımı daraltıyor. Başka bir deyişle, model eğitim sırasında zaten mükemmel performans gösterdiği kısımlara odaklanmayı sürdürürken, öğrenmesi gereken yeni alanlar ihmal ediliyor.
TailSFT ise bu dizileri eğitim sırasında filtreliyor ve öğrenmenin modelin yeterince iyi modellemediği veri kuyruğuna yoğunlaşmasını sağlıyor. Araştırmacılar bu tek değişikliğin sonuçları dramatik biçimde iyileştirdiğini belirtiyor.
Et Çarpıcı Sonuçlar: Kodlama ve Matematikte Büyük Sıçrama
OLMo-3 7B modeli üzerinde yapılan testlerde, kodlama alanında pass@16 performansı 16.8 puan, matematikte ise 3.1 puan iyileşme gözlendi. Bu yüksek kapsamlı kontrol noktaları, GRPO sonrası pass@1’de 3.9 puana kadar artış sağladı. Bazı ayarlarda erken ödül, eşleşen standart SFT çalışmasına kıyasla 2.5 kat daha hızlı yükseldi.
Bu sonuçlar, SFT ardışık düzeninin RL için doğru temeli hazırlayıp hazırlamadığı sorusunu yeniden gündeme getiriyor. ekibi, mevcut standart yaklaşımın yetersiz olduğunu kanıtlamış görünüyor.
TailSFT Microsoft Araştırmasının Etkisi
TailSFT araştırması, hem akademik hem de endüstriyel yapay zeka topluluğunda büyük ilgi görüyor. Standart SFT ardışık düzenlerinin yeniden değerlendirilmesi gerektiğini gösteren bu çalışma, özellikle büyük dil modellerinin RL sonrası optimizasyonu konusunda yeni bir sayfa açabilir.
Araştırma, basit bir filtreleme mekanizmasının eğitim verimliliğini nasıl bu denli artırabildiğini göstererek, yapay zeka topluluğuna önemli bir ders veriyor.
Yapay zeka araştırmalarındaki son gelişmeler için aihaber.org‘u düzenli olarak takip edin.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/tailsft-microsoft-yapay-zeka-egitim-2026/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın