


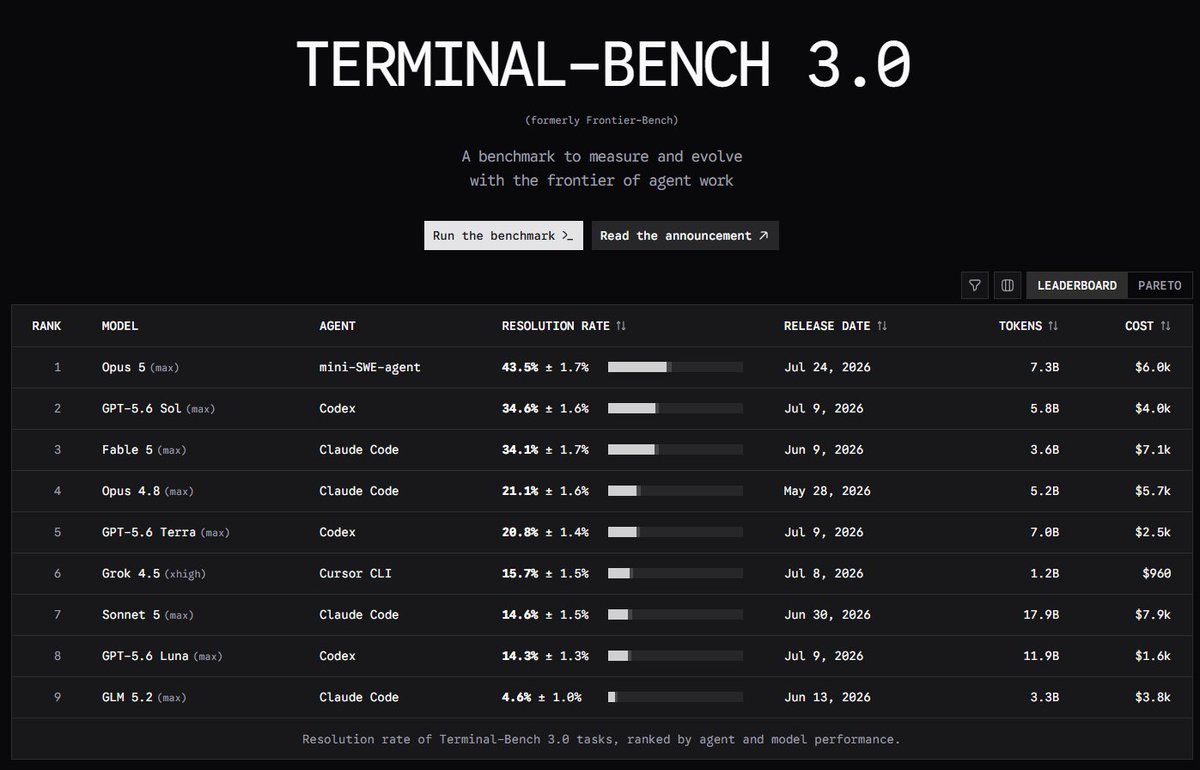

Terminal-Bench 3.0, yapay zeka terminal ajanlarini degerlendirmek için kullanilan kapsamli bir benchmark olarak piyasaya suruldu. Claude Opus 5 Max Zirveye Yerlesti Benchmark sonuclarina gore Claude Opus 5 Max, yuzde 43.5lik bir SoTA skoru elde ederek tahtini devraldi. … Fable 5 Ucuncu Sirada Fable 5, yuzde 34.1lik skoruyla ucuncu sirada yer aldi. Bu sonuc, Fable 5in GPT-5.6 Solun hata payi icinde kaldigini v…
- Terminal-Bench 3.0, yapay zeka terminal ajanlarini degerlendirmek için kullanilan kapsamli bir benchmark olarak piyasaya suruldu.
- Claude Opus 5 Max Zirveye Yerlesti Benchmark sonuclarina gore Claude Opus 5 Max, yuzde 43.5lik bir SoTA skoru elde ederek tahtini devraldi. …
- Fable 5 Ucuncu Sirada Fable 5, yuzde 34.1lik skoruyla ucuncu sirada yer aldi. Bu sonuc, Fable 5in GPT-5.6 Solun hata payi icinde kaldigini v…
Terminal-Bench 3.0, yapay zeka terminal ajanlarini degerlendirmek için kullanilan kapsamli bir benchmark olarak piyasaya suruldu.
Terminal-Bench 3.0, yapay zeka terminal ajanlarini degerlendirmek için kullanilan kapsamli bir benchmark olarak piyasaya suruldu. Bu yeni surum, yapay zeka modellerinin gercek dunya gosterlerindeki performansini olcmek icin tasarlandi.
Claude Opus 5 Max Zirveye Yerlesti
Benchmark sonuclarina gore Max, yuzde 43.5lik bir SoTA skoru elde ederek tahtini devraldi. Bu skor, GPT-5.6 Solun yuzde 34.6lik performansini geride birakirken, modeller arasindaki rekabetin ne denli cekismeli gectigini gosteriyor.
Fable 5 Ucuncu Sirada
Fable 5, yuzde 34.1lik skoruyla ucuncu sirada yer aldi. Bu sonuc, Fable 5in GPT-5.6 Solun hata payi icinde kaldigini ve rekabetin oldukca yakin oldugunu gosteriyor.
Benchmark Neden Onemli?
Terminal-Bench, ajan tabanli yapay zeka sistemlerinin performansini olcmek icin kritik bir referans noktasi sunuyor. Modellerin gercek dunya senaryolarinda nasil performans gosterdigini degerlendirmek, hem arastirmacilar hem de isletmeler icin hayati onem tasiyor.
Claude Opus 5 Maxin bu basarisi, Anthropicin model gelistirme suresinde kaydettigi ilerlemenin somut bir gostergesi olarak degerlendiriliyor. Yapay zeka yarisinda rekabetin 2026da daha da kizismasi bekleniyor.
Sonuc ve Degerlendirme
Terminal-Bench 3.0 sonuclari, yapay zeka modelleri arasindaki rekabetin tek bir modelin dominasyonu yerine coklu oyuncularin one ciktigi bir doneme evrildigini gosteriyor. Claude Opus 5 Maxin zirvedeki konumu, Anthropicin ust duzey yapay zeka modelleri gelistirmedeki kararliligini bir kez daha kanitliyor.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/terminal-bench-3-claude-opus-5-max-zirvede-2/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.


Yorum yazın