


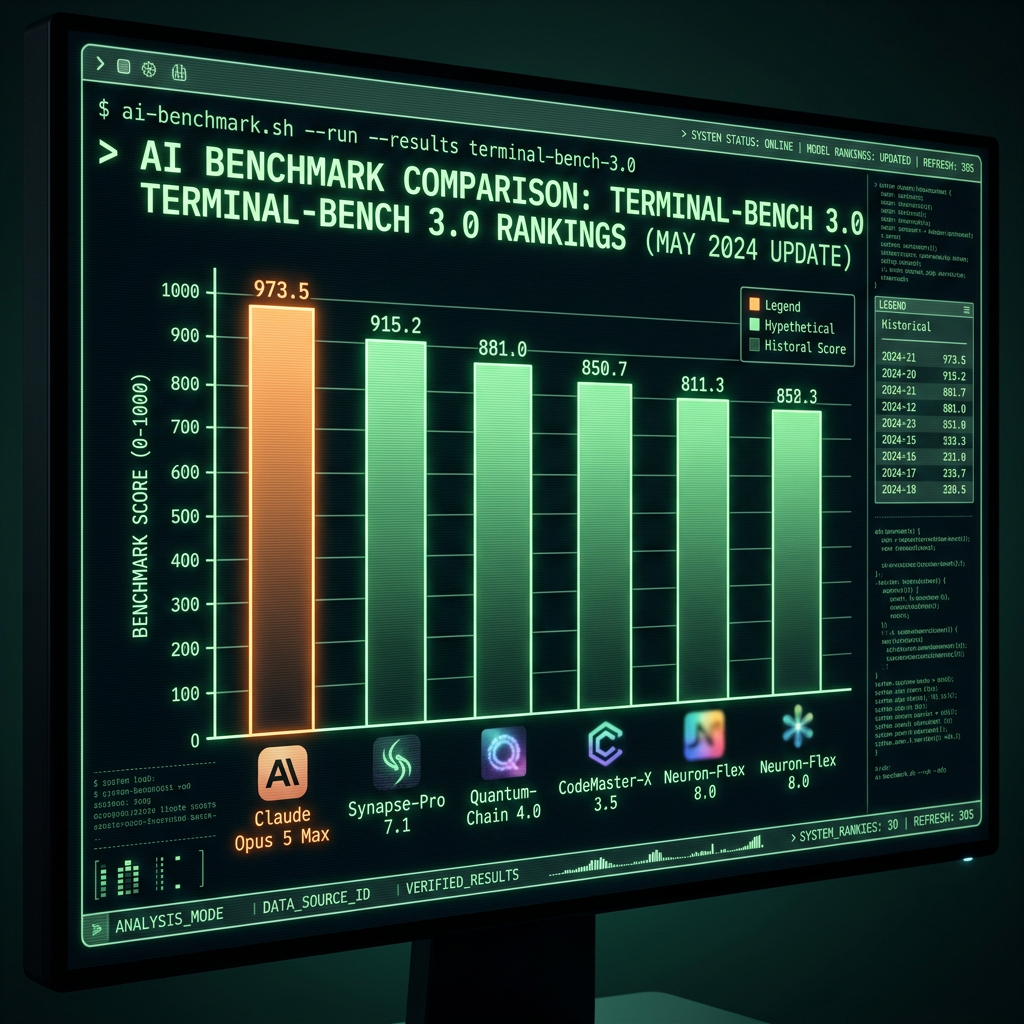

Terminal-Bench 3.0, yapay zeka modellerinin gerçek kodlama görevlerindeki başarısını ölçen önemli bir benchmark sistemi olarak yeniden gündemde. Terminal-Bench, yapay zeka modellerini izole edilmiş problem çözme görevler yerine gerçek yazılım geliştirme senaryolarında değerlendirmesiyle biliniyor. Claude Opus 5 Max'ın Terminal-Bench 3.0'da elde ettiği bu başarı, özellikle karmaşık, çok adımlı mühendislik görevlerindeki performansına bağlanıyor.
- Terminal-Bench 3.0, yapay zeka modellerinin gerçek kodlama görevlerindeki başarısını ölçen önemli bir benchmark sistemi olarak yeniden gündemde.
- Terminal-Bench, yapay zeka modellerini izole edilmiş problem çözme görevler yerine gerçek yazılım geliştirme senaryolarında değerlendirmesiyle biliniyor.
- Claude Opus 5 Max'ın Terminal-Bench 3.0'da elde ettiği bu başarı, özellikle karmaşık, çok adımlı mühendislik görevlerindeki performansına bağlanıyor.
Terminal-Bench 3.0, yapay zeka modellerinin gerçek kodlama görevlerindeki başarısını ölçen önemli bir benchmark sistemi olarak yeniden gündemde.
Terminal-Bench 3.0, yapay zeka modellerinin gerçek kodlama görevlerindeki başarısını ölçen önemli bir benchmark sistemi olarak yeniden gündemde. Yeni sürümde Max, zirvedeki yerini GPT serisinden alarak tahtı devraldı. Bu sonuç, kodlama benchmarkları arenasında rekabetin ne kadar çekişmeli olduğunu bir kez daha gözler önüne serdi.
Terminal-Bench, yapay zeka modellerini izole edilmiş problem çözme görevler yerine gerçek yazılım geliştirme senaryolarında değerlendirmesiyle biliniyor. Bu yaklaşım, model gerçek dünya kodlama yetenekleri hakkında daha doğru bir tablo sunuyor.
Claude Opus 5 Max Neden Zirvede?
Claude Opus 5 Max’ın Terminal-Bench 3.0’da elde ettiği bu başarı, özellikle karmaşık, çok adımlı mühendislik görevlerindeki performansına bağlanıyor. Raporlara göre model, sadece doğru cevabı üretmekle kalmıyor, aynı zamanda kod kalitesi, sürdürülebilirlik ve hata yönetimi açısından da üstün sonuçlar veriyor.
Bu sonuç, yapay zeka kodlama asistanları arasındaki rekabetin tek bir model etrafında kümelenmediğini gösteriyor. , , ve xAI gibi şirketler arasındaki yarış, hangi modelin en iyi kod ürettiği konusunda sürekli bir geri planda kalmış görünüyor.
Benchmark Savaşları ve Gerçek Kodlama Performansı
Terminal-Bench sonuçları, laboratuvar testleri ile gerçek dünya performansı arasındaki farkın altını çiziyor. Birçok uzman, modellerin benchmark tablolarındaki sıralamalarının her zaman günlük kodlama deneyimini yansıtmadığını belirtiyor. Bazı durumlarda, listede alt sıralarda yer alan bir model belirli görevlerde daha üstün performans gösterebiliyor.
Bununla birlikte Terminal-Bench 3.0’ın güncellenmiş değerlendirme kriterleri, model karşılaştırmalarını daha şeffaf hale getiriyor. Yeni sürüm, gerçek kod tabanlarında karşılaşılan sorunları daha iyi simüle eden senaryolar içeriyor.
Rekabetin Geleceği
Claude Opus 5 Max’ın zirveye oturması, yapay zeka kodlama pazarındaki güç dengesinin sürekli değiştiğini gösteriyor. GPT serisinin uzun süredir dominance ettiği bu alanda Anthropic’in elde ettiği bu başarı, OpenAI ve diğer şirketleri yeni adımlar atmaya teşvik edebilir.
Önümüzdeki dönemde, ajan tabanlı kodlama sistemlerinin (agentic coding) yükselişiyle birlikte benchmark savaşlarının yeni bir boyut kazanması bekleniyor. Modellerin sadece kod üretmekle kalmayıp, bağımsız olarak karmaşık yazılım projelerini yönetebilmesi, değerlendirme kriterlerini de kökten değiştirebilir.
Kaynak: Terminal-Bench resmi verileri
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/terminal-bench-3-claude-opus-5-max/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.
Yorum yazın