
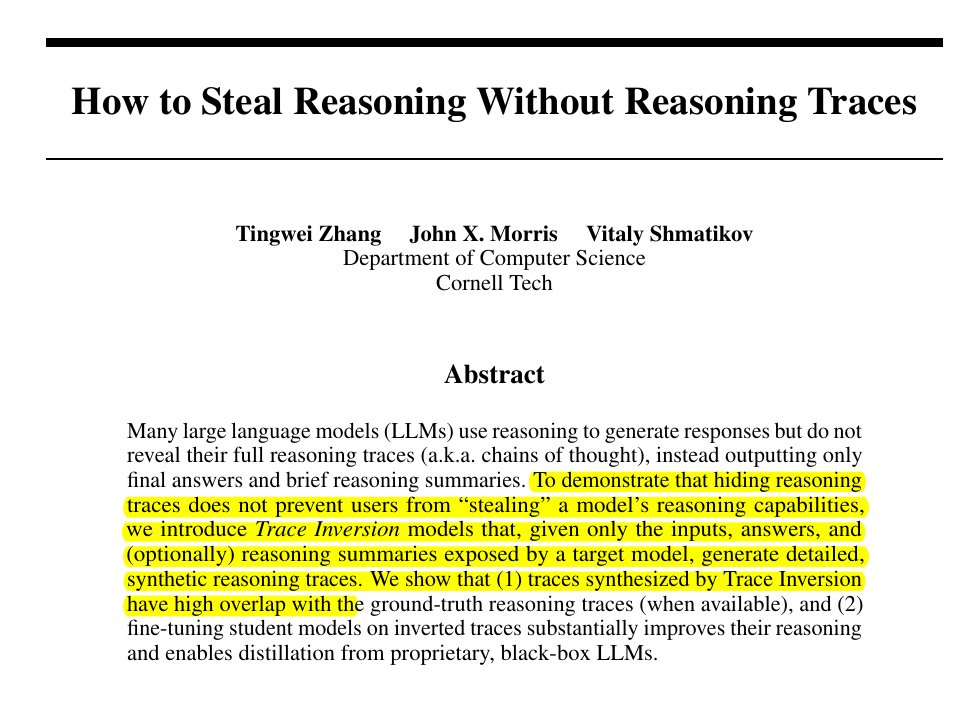
Yeni bir araştırma, güçlü yapay zeka modellerinin akıl yürütme yeteneklerinin yalnızca 173 dolarlık API çağrısıyla kopyalanabileceğini ortaya koydu. “Trace Inversion” (İz Tersine Çevirme) adı verilen bu saldırı yöntemi, bir yapay zeka modelinin dahili akıl yürütme sürecini görmeden de yeteneklerinin büyük bölümünün çıkarılabileceğini kanıtlıyor.
Araştırmacılar, saldırının çalışması için yapay zeka modeline yalnızca sorulan soruyu, verilen son yanıtı ve isteğe bağlı olarak kısa bir akıl yürütme özetini almak yeterli. Bu üç öğe, düşük maliyetli bir inversiyon modeli aracılığıyla binlerce sentetik akıl yürütme zinciri üretmek için kullanılıyor.
Trace Inversion Saldırısı Nasıl Çalışıyor?
Geleneksel saldırı yöntemlerinden farklı olarak Trace Inversion, modelin ” düşünce zincirini” (chain-of-thought) doğrudan görmek yerine yalnızca nihai çıktılarından yararlanıyor. Araştırmacıların ifadesiyle, “izler gerçek dahili akıl yürütmeyle eşleşmek zorunda değil; yeterli denetim sağladıkları sürece iş görüyor.”
Süreç şu adımlarla işliyor:
Öncelikle açık akıl yürütme yeteneklerine sahip bir model üzerinde inversiyon modeli eğitiliyor. Bu model, kara kutu yapay zeka sistemlerinin son yanıtlarından kapsamlı sentetik akıl yürütme izleri sentezliyor. Elde edilen sentetik izler, bir “öğrenci modeli”ni eğitmek için kullanılıyor. Böylece pahalı ve karmaşık saldırı araçlarına gerek kalmadan, herhangi bir geliştirici bu izleri yeniden üretebiliyor.
Maliyet: Yalnızca 173,28 Dolar
Araştırma ekibi, saldırının ekonomik boyutunu da gözler önüne seriyor. 10 bin adet GPT-5.4 mini API sorgusu toplamak yalnızca 173,28 dolara mal oluyor. Bu rakam, gelişmiş yapay zeka yeteneklerini çıkarmayı geniş bir tehdit aktörü yelpazesi için erişilebilir kılıyor.
Bir başka deyişle, saldırganın bütçe kısıtlaması artık bir engel olmaktan çıkıyor. Düşük maliyet, Trace Inversion’ı yalnızca devlet destekli aktörlerin değil, bireysel araştırmacıların ve küçük ölçekli tehdit aktörlerinin bile erişimine açıyor.
Zincir Görme Savunmaları Artık Yeterli Değil
Bu bulgular, yapay zeka güvenliği alanında kritik bir dönüm noktasına işaret ediyor. Mevcut savunma mekanizmalarının büyük bölümü, akıl yürütme süreçlerini görünür kılmaya veya gizlemeye dayanıyor. Ancak Trace Inversion saldırısı, bu yaklaşımın artık güvenilir olmadığını ortaya koyuyor.
Araştırmacılar, “zincir görme süreçlerini gizlemek veya bulanıklaştırmak, şeffaflığı azaltabilir ancak yetenek aktarımını güvenilir şekilde engelleyemez” diyor. Saldırgan, API çağrısından sonra eksik eğitim sinyalini üretebiliyor.
Bu durum, yapay zeka geliştiricilerinin güvenlik stratejilerini köklü şekilde yeniden düşünmesi gerektiği anlamına geliyor. Zincir-içi düşünce koruması yerine, çıktı tabanlı yetenek çıkarımına karşı yeni nesil koruma mekanizmaları geliştirilmesi zorunlu hale geliyor.
Araştırmanın Yapay Zeka Güvenliği İçin Anlamı
Trace Inversion araştırması, yapay zeka güvenliği literatürüne birkaç önemli katkı sağlıyor. İlk olarak, kara kutu ortamında bile kapsamlı yetenek çıkarımının mümkün olduğunu kanıtlıyor. İkinci olarak, savunmacıların zincir görünürlüğü ile yetenek güvenliği arasındaki dengeyi yeniden değerlendirmesi gerektiğini ortaya koyuyor.
Üçüncü olarak, yetenek aktarımının önlenmesinin artık yalnızca erişim kontrolüyle değil, daha kapsamlı bir güvenlik mimarisiyle ele alınması gerektiğini gösteriyor.
Yapay zeka labaratuvarları ve API sağlayıcıları için bu araştırma, akıl yürütme izlerinin korunmasının ötesinde, model çıktılarından yetenek çıkarımına karşı da koruma sağlanması gerektiğini açıkça ortaya koyuyor.
Kaynak: Rohan Paul (@rohanpaul_ai) / X, Ağustos 2026
Henüz yorum yok. İlk yorumu siz yapın!