CANLI
xAI, Imagine API’yi 2.0’a Yükseltmeye Hazırlanıyor: Görüntü ve Video Tek…·Microsoft MAI-Cyber-1-Flash’ı Duyurdu·Moonshot AI, Kimi K3 Model Ağırlıklarını ve Teknik Raporunu Açık…
1 Oct 2026 · 22:18 GMT+3
Ai Haber – Türkiyenin Yapay Zeka Haber Portalı
AI ARAçLARı SAYI #2.743 1 Eki 2026 · Perşembe

vLLM ayrıştırılmış serving rehberi: prefill/decode ve GPU’suz frontend

vLLM ekibi, tek bir vllm serve sürecinin prefill, decode ve CPU işlerini bir arada yapmasının yüksek eşzamanlılıkta akışları nasıl kilitlediğini anlatan disaggregated serving pratik rehberini…

AiHaber Editör
Editör
1DK 10OKUMA

★ Hızlı Özet

  • vLLM ekibi, tek bir vllm serve sürecinin prefill, decode ve CPU işlerini bir arada yapmasının yüksek eşzamanlılıkta akışları nasıl kilitledi…
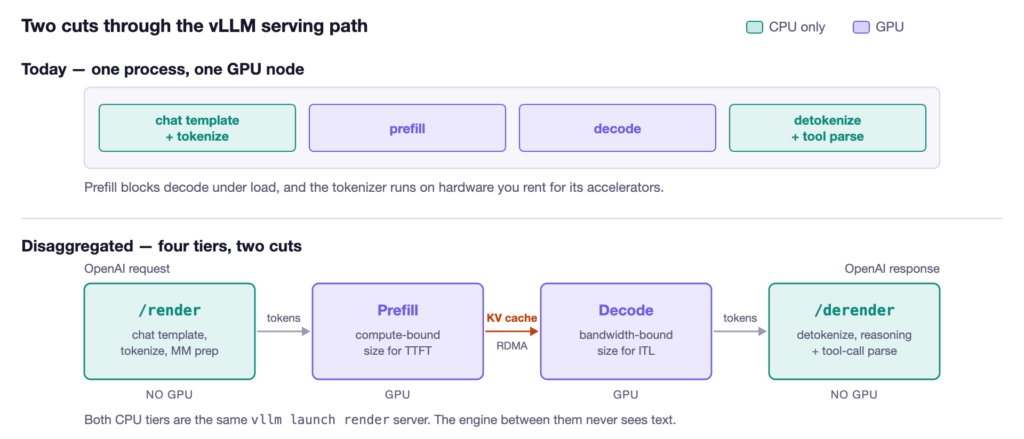
  • Ne ayrılıyor? Prefill: tüm istemi bir geçişte işler, TTFT’yi belirler, hesaplama sınırlı Decode: token token üretir, bellek bant genişliği …

vLLM ekibi, tek bir vllm serve sürecinin prefill, decode ve CPU işlerini bir arada yapmasının yüksek eşzamanlılıkta akışları nasıl kilitlediğini anlatan disaggregated serving pratik rehberini yayınladı.

Ne ayrılıyor?

  • Prefill: tüm istemi bir geçişte işler, TTFT’yi belirler, hesaplama sınırlı
  • Decode: token token üretir, bellek bant genişliği / ITL odaklı
  • CPU frontend: tokenization, şablon, araç/akıl yürütme ayrıştırma — GPU düğümünden çıkarılıp /render ve /derender ile token ID üzerinden motor beslenir

Prefill ile decode ayrıldığında uzun istemlerin diğer yanıtları durdurmaması için KV önbelleğinin hızlı taşınması gerektiği vurgulanıyor. Rehber vLLM v0.30.0+ ile uçtan uca kurulum, ne zaman ayrıştırmanın değeceği ve hâlâ açık boşlukları kapsıyor.

Kaynak: vLLM: Disaggregated Serving Guide

— Paylaş

Beğendiysen yay.

Yapay Zeka Sohbetlerinde
Sosyal Medyada

Tartışma

Bu habere emoji ile tepki ver

Hizli:

Henüz yorum yok. İlk yorumu siz yapın!

Yapıcı ve saygılı yorumlar bekliyoruz. Topluluk kuralları