
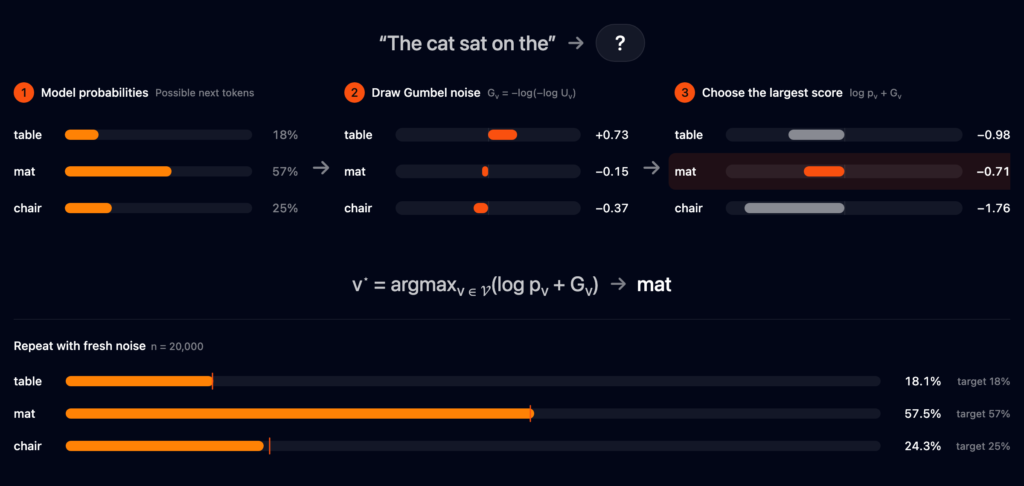
vLLM ekibi 24 Eylül 2026’da blogunda, dil modeli çıktılarına dağılımı bozmayan (distortion-free) metin filigranı desteğini duyurdu. Yöntem Gumbel-max örneklemesine dayanıyor; yazarlar Raphaël Rialland (Mistral) ile Simon Veitner ve Tomas Ruiz (Red Hat).
Neden Gumbel-max?
Metin ayrık olduğu için görüntü/ses filigranındaki küçük bozunumlar uygulanamıyor. vLLM, her adımda aday token’lara anahtarlı sözde-rastgele Gumbel gürültüsü ekleyip argmax ile seçiyor. Anahtar ve son bağlam (varsayılan son 4 token) bilindiğinde dedektör aynı değerleri yeniden üretebiliyor; anahtarsız gözlemci için çıktı sıradan rastgele örnekleme gibi görünüyor. Beklenen seçim olasılığı korunuyor.
Algılama model ağırlığı veya logit gerektirmiyor; gizli anahtar ve tokenizer yeterli. Token skorları toplanıp filigransız metnin Gamma dağılımıyla karşılaştırılarak p-değeri üretiliyor.
vLLM uygulaması ve zorluklar
Özellik Model Runner v2 örnekleme hattına bağlandı (PR #54053). Naif [batch, vocabulary] gürültü tensörü yerine PRNG, Gumbel dönüşümü ve argmax tek bir GPU çekirdeğinde birleştirildi. Qwen3.5-27B ölçümlerinde filigranlı/filigransız throughput eğrileri örtüşüyor; sekiz anahtarda ortalama eşleşmiş değişim yaklaşık −1,1% ile +2,0% arası.
Spekülatif çözümlemede aynı filigranın draft ve target’a uygulanması kabul oranını düşürebildiği için çift anahtar şeması kullanılıyor (PR #56122): kabul edilen draft token’lar bir anahtar, residual/bonus token’lar diğeri. Tekrarlayan bağlamın aynı gürültüyü üretip çeşitliliği düşürmesini önlemek için üretim sırasında bağlam tekilleştirme eklendi (PR #56233); Qwen3.5-27B’de uçtan uca throughput kaybı en fazla ~%0,19.
Nasıl açılır?
Sunucu başlatırken örnek yapılandırma:
vllm serve mistralai/Mistral-7B-Instruct-v0.3 \ --watermark-config '{"algorithm":"gumbel","key":42}'Eşleşen tokenizer ve anahtarla metin kontrolü için minimal HTTP algılama sunucu örneği belgelerde yer alıyor.
Henüz yorum yok. İlk yorumu siz yapın!