


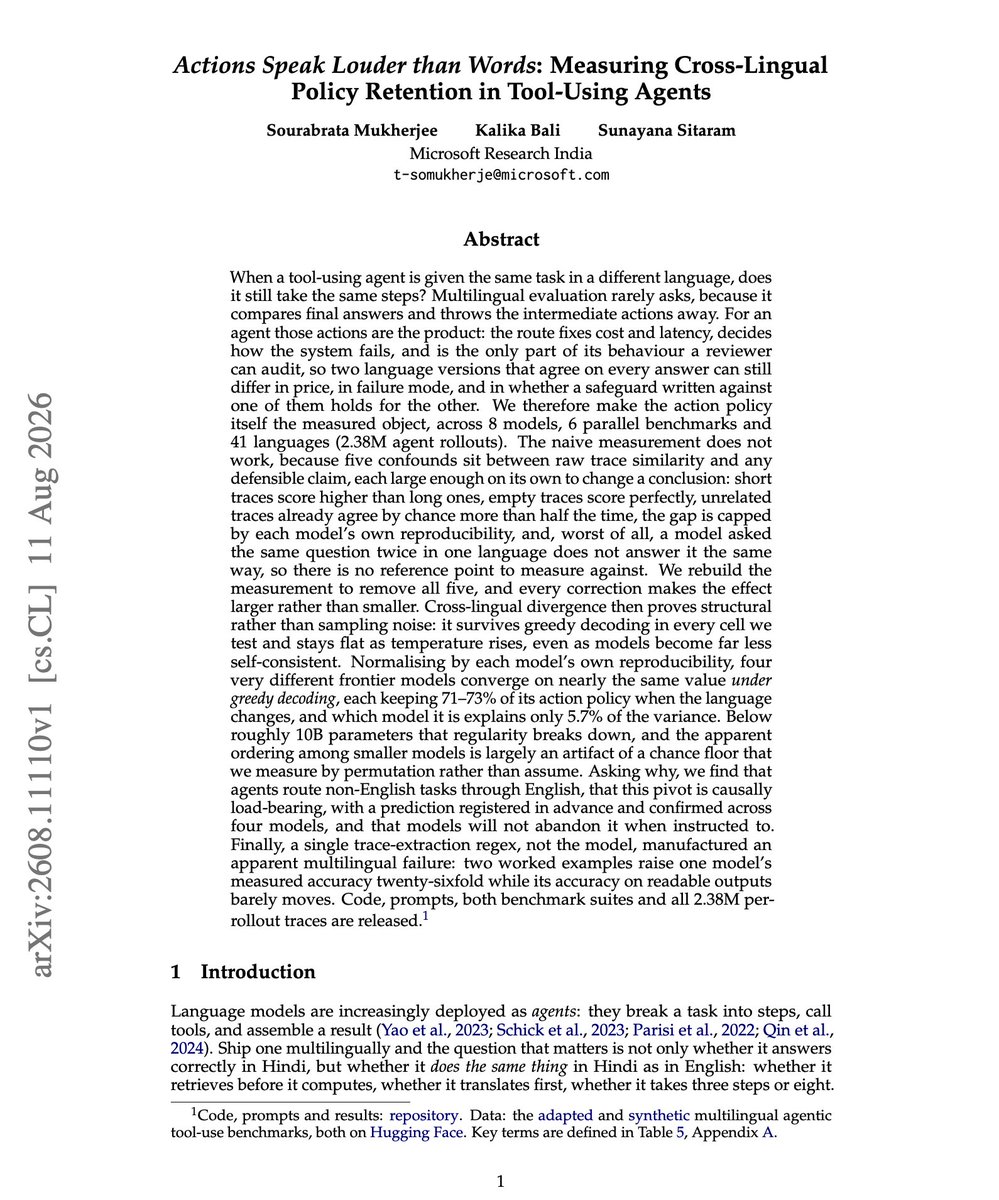

Microsoft Research, yapay zeka ajanlarının çok dilli ortamlarda nasıl performans gösterdiğini inceleyen kapsamlı bir araştırma yayımladı. Araştırmanın Kapsamı Çalışma, 8 farklı model, 6 paralel kıyaslama ve 41 dilde toplam 2,38 milyon deneme üzerinden yürütüldü. Araştırmacılar,… Temel Bulgular Normalizasyon sonrasında, dört farklı sınır modelinin her biri diller arasında %71-73 oranında eylem politikasını koruyabildi…
- Microsoft Research, yapay zeka ajanlarının çok dilli ortamlarda nasıl performans gösterdiğini inceleyen kapsamlı bir araştırma yayımladı.
- Araştırmanın Kapsamı Çalışma, 8 farklı model, 6 paralel kıyaslama ve 41 dilde toplam 2,38 milyon deneme üzerinden yürütüldü. Araştırmacılar,…
- Temel Bulgular Normalizasyon sonrasında, dört farklı sınır modelinin her biri diller arasında %71-73 oranında eylem politikasını koruyabildi…
Microsoft Research, yapay zeka ajanlarının çok dilli ortamlarda nasıl performans gösterdiğini inceleyen kapsamlı bir araştırma yayımladı.
Research, yapay zeka ajanlarının çok dilli ortamlarda nasıl performans gösterdiğini inceleyen kapsamlı bir araştırma yayımladı. “Actions Speak Louder than Words” başlıklı çalışma, yapay zeka çok dilli ajan değerlendirmesi alanında önemli bulgular sunuyor.
Araştırmanın Kapsamı
Çalışma, 8 farklı model, 6 paralel kıyaslama ve 41 dilde toplam 2,38 milyon deneme üzerinden yürütüldü. Araştırmacılar, geleneksel değerlendirme yöntemlerinin yanıltıcı olabileceğini ortaya koydu: mevcut yaklaşımlar yalnızca sonuçları karşılaştırıyor ve ajanın izlediği yolu tamamen göz ardı ediyor.
Temel Bulgular
Normalizasyon sonrasında, dört farklı sınır modelinin her biri diller arasında %71-73 oranında eylem politikasını koruyabildi. Model kimliği, varyansın yalnızca %5,7’sini açıklıyor — bu da dil tutarlılığının modelden bağımsız olarak yapısal olduğunu gösteriyor.
Küçük modellerde (10 milyar parametrenin altında) bu tutarlılık bozuluyor. Küçük modellerin sıralaması büyük ölçüde bir tesadüf zeminine bağlı.
İngilizce Pivot Dili Olarak
En dikkat çekici bulgu: Ajanlar, İngilizce olmayan görevleri İngilizceye yönlendiriyor. Bu pivot davranışı yapısal olarak kritik ve nedensel olarak yüklenebilir durumda. Modeller, buna doğrudan yönlendirilseler bile bu stratejiden vazgeçmiyor.
Ölçüm Hataları Sonuçları Çarpıtabilir
Araştırmacılar, standart değerlendirmelerin beş farklı karıştırıcı faktör nedeniyle başarısız olabileceğini tespit etti: kısa izler daha yüksek puan alıyor, boş izler mükemmel puan veriyor, ilgisiz izler şans eseri yarıdan fazla örtüşüyor. Bu faktörlerin hepsi bir sonucu tersine çevirebilecek güce sahip.
Kaynak: @dair_ai / X | Araştırma Makalesi (arXiv)
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/yapay-zeka-cok-dilli-ajan-degerlendirme-arastirmasi/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.


Yorum yazın