
Kısaca · 3 madde
- 1Bir yapay zeka modelinin gerçek performansını ölçmek, sandığımızdan çok daha karmaşık bir iş.
- 2Kıyaslama Puanları Nokta Değil, Bant Araştırmacı V.S. Raghu Parupudi’nin yayınladığı makaleye göre bir modelin puanı, gerçek yeteneklerinden…
- 3Dırıngan Kalemler Sonucu Belirliyor Her iki modelin de stabil şekilde cevapladığı kalemlerde modeller berabere kalıyor. Ancak yapılandırmaya…
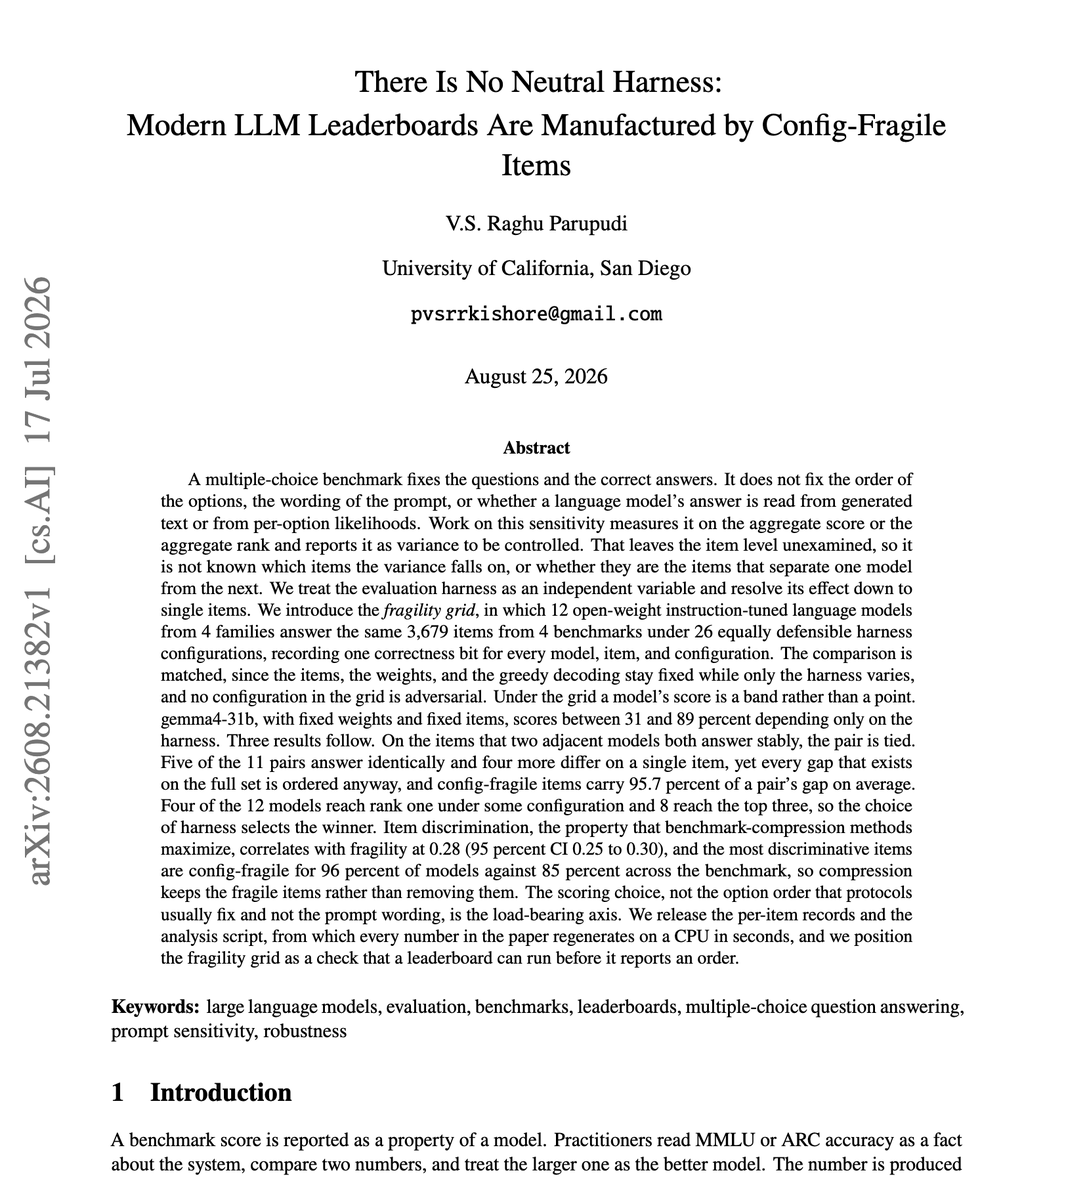
Bir yapay zeka modelinin gerçek performansını ölçmek, sandığımızdan çok daha karmaşık bir iş. Yeni bir akademik çalışma, mevcut LLM kıyaslamalarının büyük ölçüle yanlış sonuçlar üretiyor olabileceğini gösteriyor. Çalışmanın merkezinde, kıyaslaması yapılandırmasının (harness) sonuçları nasıl dramatik şekilde değiştirebileceği yer alıyor.
Kıyaslama Puanları Nokta Değil, Bant
Araştırmacı V.S. Raghu Parupudi’nin yayınladığı makaleye göre bir modelin puanı, gerçek yeteneklerinden değil, değerlendirme kıyaslamasının yapılandırmasına bağlı olarak önemli ölçüle değişiyor. Örneğin Gemma 4-31b modeli, yalnızca kıyaslama yapılandırmasına bağlı olarak yüzde 31 ile yüzde 89 arasında puan alabiliyor.
Dırıngan Kalemler Sonucu Belirliyor
Her iki modelin de stabil şekilde cevapladığı kalemlerde modeller berabere kalıyor. Ancak yapılandırmaya duyarlı (config-fragile) kalemler, bitişik modeller arasındaki performans farkının yüzde 95,7’ini oluşturuyor. Bu da kıyaslama sonuçlarının büyük ölçüle tesadüfi olabileceğini düşündürüyor.
Dört Farklı Model Aynı Kıyaslamada Birinci Olabiliyor
Çalışmada değerlendirilen 12 modelden dördü, yalnızca kıyaslama yapılandırmasını değiştirerek birinci sıraya yerleşebiliyor. Bu bulgu, mevcut LLM sıralamalarının ne kadar çok yönlü olabileceğini gösteriyor. Yapılandırma seçimi, kazananı belirleyen temel faktör haline gelmiş durumda.
Benchmark Sıkştırma Yöntemleri Sorunu
Çalışmanın bir diğer kritik bulgusu şu: “Item discrimination” (kalem ayırt etme) metriği, benchmark sıkştırma yöntemlerinin maksimize ettiği bir gösterge. Ancak bu metrik, kıyaslama sıkştırma yöntemlerinin en fazla yapılandırmaya duyarlı kalemleri seçmesine yol açıyor — yani sıkştırılmış benchmark’lar en sorunlu kalemleri koruyor.
Puanlama Yöntemi Önemli, Seçenek Sırası Değil
Araştırmacılar, puanlama yönteminin (modelin üretilen metinden mi yoksa her seçenek için olasılıktan mı okunduğu) sonuçlar üzerinde en etkili faktör olduğunu tespit etti. Seçenek sırasının etkisi ise beklenenden daha düşük kaldı.
Bu bulgular, yapay zeka kıyaslamalarının nasıl yorumlanması gerektiği konusunda ciddi sorular gündeme getiriyor. Araştırmacılar, model karşılaştırmalarında birden fazla kıyaslama yapılandırması kullanılmasının zorunlu olduğunu vurguluyor.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/yapay-zeka-kiyaslama-harness-yaniltmasi/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın