



SWE-bench Science Nedir? Belirti Düzeltmede %96, Gizli Testlerde %48 Araştırmanın en çarpıcı bulgusu şudur: yapay zeka kodlama ajanları, halka açık testlerde yüzde 9… Sağlanan Alan Bilgisi Güvenilir Bir Çözüm Sunmuyor Araştırmacılar, ajanlara ek alan bilgisi veya bilimsel bağlam sağlandığında bile performa…
- SWE-bench Science Nedir?
- Belirti Düzeltmede %96, Gizli Testlerde %48 Araştırmanın en çarpıcı bulgusu şudur: yapay zeka kodlama ajanları, halka açık testlerde yüzde 9…
- Sağlanan Alan Bilgisi Güvenilir Bir Çözüm Sunmuyor Araştırmacılar, ajanlara ek alan bilgisi veya bilimsel bağlam sağlandığında bile performa…
SWE-bench Science Nedir?
SWE-bench Science Nedir?
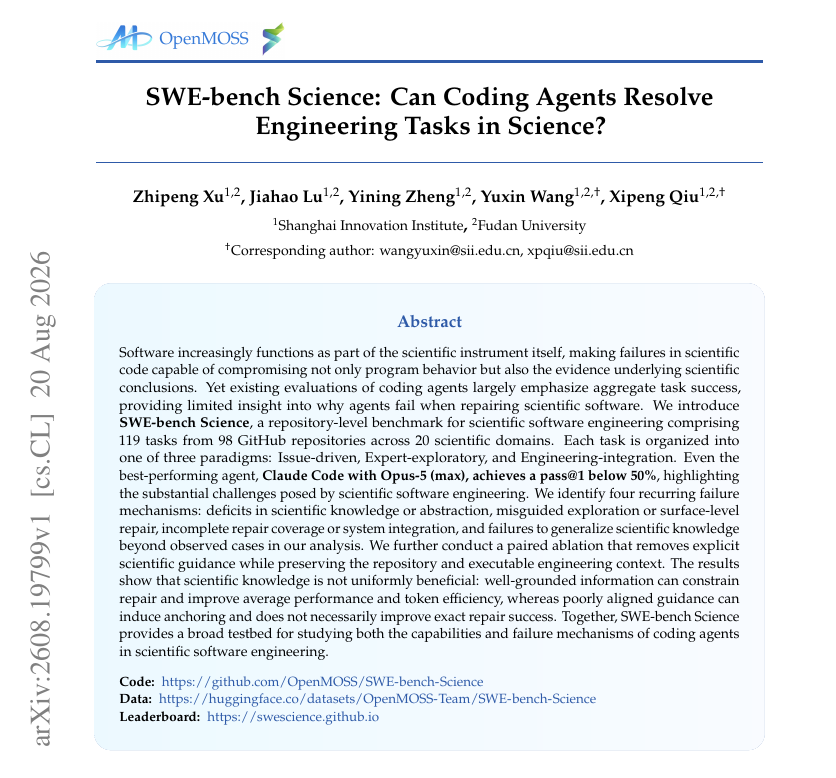
SWE-bench Science, yapay zeka kodlama ajanlarını gerçek bilimsel yazılım mühendisliği görevlerinde test eden kapsamlı bir değerlendirme çerçevesidir. Araştırmacılar, bu çalışmada aracıların açık bilimsel yazılım havuzlarından aldıkları gerçek hataları çözme becerisini ölçtü. Halka açık testler, ajanların görebildiği ve yinelemeli olarak çözebildiği testler olarak ayrı tutulurken, gizli testler ajanların hiç görmediği doğrulama noktaları olarak kullanıldı.
Belirti Düzeltmede %96, Gizli Testlerde %48
Araştırmanın en çarpıcı bulgusu şudur: yapay zeka kodlama ajanları, halka açık testlerde yüzde 96,64 gibi yüksek bir başarı oranına ulaşabiliyor. Ancak aynı ajanlar, hiç görmedikleri gizli testlerde yalnızca yüzde 47,90 Pass@1 oranına düşüyor. BuPass@1 metriği, her gizli testin tek bir denemede geçmesini gerektiriyor ve ajanın genelleme kapasitesini katı biçimde ölçüyor.
Sağlanan Alan Bilgisi Güvenilir Bir Çözüm Sunmuyor
Araştırmacılar, ajanlara ek alan bilgisi veya bilimsel bağlam sağlandığında bile performans artışının sınırlı kaldığını tespit etti. Yapay zeka kodlama ajanları, kendilerine verilen açıklamalara tutarlı biçimde tutunabiliyor ancak bu açıklamaları çalıştırılabilir kanıtlarla test etmekte zorlanıyor. Bu durum, ajanların belirli bir çözüm yolunu benimsemesine yol açıyor; ancak bu yolun gerçekte doğru olup olmadığını doğrulayamıyorlar.
Temel Sorun: Doğrulama, Bilgi Değil
Çalışmanın varış noktası kritik bir ayrıntıyı gözler önüne seriyor. Ajanların asıl sınırlılığı bilgi eksikliği değil, doğrulama yetersizliğidir. Bir yapay zeka kodlama ajanı, sağlanan bilimi çalıştırılabilir kanıtlarla karşılaştıramıyorsa, açıklamaya güvenmek yerine test etmeyi seçemiyor. Bu da halka açık testlerde görünür başarısızlıkları düzeltebiliyor ancak kök nedendeki hatayı kaçırabiliyor.
Claude Code Opus-5 ile En Yüksek Sonuç
Test edilen tüm yapılandırmalar arasında Claude Code Opus-5 kombinasyonu en iyi performansı sergiledi. Bununla birlikte bu sonuç bile, ajan tabanlı kodlama sistemlerinin gerçek dünya mühendislik görevlerinde hâlâ önemli sınırlılıklarla karşı karşıya olduğunu ortaya koyuyor. Yüksek başarı oranları, ajanın sorunu doğru anladığı anlamına gelmiyor — yalnızca verilen test setine uyum sağladığı anlamına geliyor.
Yapay Zeka Kodlama Ajanları İçin Çıkarımlar
SWE-bench Science bulguları, yapay zeka kodlama ajanı sistemlerinin mevcut durumunu anlamak için kritik perspektifler sunuyor. Bu sistemlerin belirtileri düzeltmede son derece yetenekli olduğu açık; ancak mühendislik açısından kritik olan kök neden analizi ve doğrulama konusunda ciddi boşluklar taşıyor. Geliştiricilerin bu ajanları üretken ortamlarda kullanırken bu sınırlılıkları göz önünde bulundurması gerekiyor.
Araştırma ayrıca gelecekteki yapay zeka kodlama ajanı sistemlerinin yalnızca bilgi tabanını genişletmekle kalmayıp aynı zamanda doğrulama mekanizmalarını güçlendirmesi gerektiğini ortaya koyuyor. Çalışmanın tamamına arXiv üzerinden ulaşılabilir.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/yapay-zeka-kodlama-ajanlari-belirti-duzeltme-swe-bench/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.


Yorum yazın