


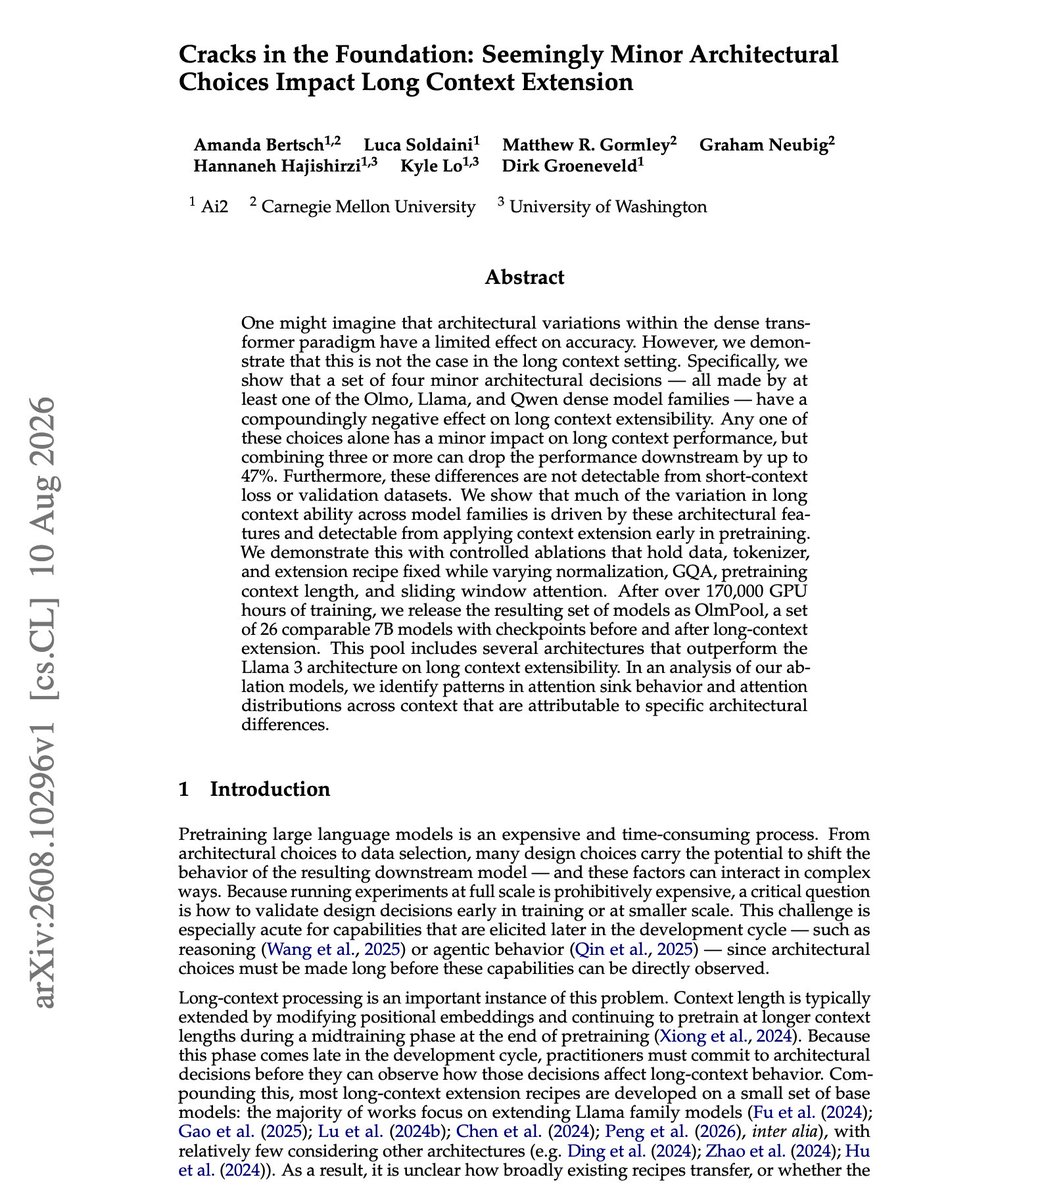

Yapay Zeka Model Mimarisi: Dort Basit Karar ile Uzun Baglam Performansi %47 Düsüyor. Ne oldu? Ai2 (Allen Institute for AI), Carnegie Mellon Üniversitesi ve Washington Üniversitesi'nden ortak bir arastirma grubu, yapay zeka mo… Bu kararlarin hepsi ayri ayri degerlendirildiginde masum görünüyor ve hiçbiri kisabakagan performans kaybina neden olmuyor.
- Yapay Zeka Model Mimarisi: Dort Basit Karar ile Uzun Baglam Performansi %47 Düsüyor.
- Ne oldu? Ai2 (Allen Institute for AI), Carnegie Mellon Üniversitesi ve Washington Üniversitesi'nden ortak bir arastirma grubu, yapay zeka mo…
- Bu kararlarin hepsi ayri ayri degerlendirildiginde masum görünüyor ve hiçbiri kisabakagan performans kaybina neden olmuyor.
Yapay Zeka Model Mimarisi: Dort Basit Karar ile Uzun Baglam Performansi %47 Düsüyor.
Yapay Zeka Model Mimarisi: Dort Basit Karar ile Uzun Baglam Performansi %47 Düsüyor
Ne oldu? Ai2 (), Carnegie Mellon Üniversitesi ve Washington Üniversitesi’nden ortak bir arastirma grubu, yapay zeka model mimarisi konusunda kritik bulgular yayimladi. Yapilan çalismaya göre, dört adet zararsiz mimari karar, bir modelin uzun baglam performansini yüzde 47’ye varan oranda düsürebiliyor.
Bu kararlarin hepsi ayri ayri degerlendirildiginde masum görünüyor ve hiçbiri kisabakagan performans kaybina neden olmuyor. Ancak üç veya daha fazlasi bir araya geldiginde, sonuçlar modelin uzun baglam yeteneklerini ciddi sekilde sinirlandiriyor.
Dort Kritik Mimari Karar ve Performans Kaybi
Yapay zeka model mimarisi arastirmalari, bu dort kritik kararin hangileri oldugunu açikça ortaya koydu: normalizasyon, GQA (Grouped Query Attention), pretraining context length ve sliding window attention. Her biri günümüzün en yaygin model ailelerinden en az biri Olmo, Llama ve Qwen dense aileleri tarafindan kullaniliyor.
Araştirmacilar, bu dort mekanizmanin tek basina zararsiz göründügünü belirtiyor. Ancak sorun, birden fazlasinin birlikte kullanildiginda ortaya çikiyor. Üç veya daha fazla karar birlikte uygulandiginda, modelin uzun baglam performansi dramatik sekilde düsüyor.
Normalizasyon, GQA, Pretraining ve Sliding Window
Normalizasyon, sinir aglarinin egitimi sirasinda gradyan akışini düzenleyen temel bir teknik. Yanlis yapilandirma, uzun baglamli görevlerde bilginin akisini bozabiliyor.
GQA (Grouped Query Attention), dikkat mekanizmasini daha verimli hale getiren bir yöntem. Ancak belirli uzun baglam senaryolarinda yeterli esnekligi saglayamayabiliyor.
Pretraining Context Length, modelin egitim asamasinda karsilastigi maksimum baglam uzunlugu. Bu degerin karsisindaki uzunlugundaki görevlerde model performansi düsüyor.
Sliding Window Attention ise hesaplama verimliligi saglarken, belirli uzun baglam iliskilerini yakalayamayabiliyor.
OlmPool: 170.000 GPU Saatinin Üretimi
Arastirma ekibi, bulgularini desteklemek için OlmPool adli yeni bir veri seti olusturdu. OlmPool, 26 karsilastirilabilir 7B modelden olusan bir set ve her birinin uzatma öncesi ve sonrasi kontrol noktalari mevcut. Bu modeller toplam 170.000 GPU saatinin üzerinde egitim süresiyle olusturuldu.
OlmPool sayesinde arastirmacilar, her bir mimari kararin uzun baglam performansina etkisini izole edebildi ve toplam etkiyi ölçebildi. Bu veri seti, gelecek model gelistiriciler için son derece degerli bir kaynak olacak.
Neden Validasyon Setlerinde Görülmüyor?
En çarpici bulgu: Bu performans kaybinin hiçbiri short-context loss veya validasyon setlerinde görülmüyor. Yani bir modelin kisa baglamli basarimi normal görünürken, uzun baglamli görevlerde ciddi kayiplar yasiyor.
Bu durum, gelistiricilerin modellerinin uzun baglam kapasitesini standart degerlendirme yöntemleriyle tespit edemeyecegi anlamina geliyor. Problemi ortaya çikarmanin yolu, egitim sürecinde erken dönemde context extension uygulamaktan geçiyor.
Sonuç ve Çikarimlar
Bu arastirma, yapay zeka model mimarisi kararlarinin ne denli kritik olabilecegini gösteriyor. Tek basina zararsiz görünen seçimler, birlikte kullanildiginda modelin yeteneklerini yüzde 47’ye varan oranda sinirlandirabiliyor.
Model gelistiriciler için altin kural: her mimari kararin uzun baglamli senaryolardaki etkisini ayri ayri test etmek ve birlikte kullanildiginda ortaya çikabilecek sorunlari erkenden tespit etmek gerekiyor.
Kaynak: DAIR.AI (@dair_ai)
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/yapay-zeka-model-mimarisi-uzun-baglam-performans/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.
Yorum yazın