
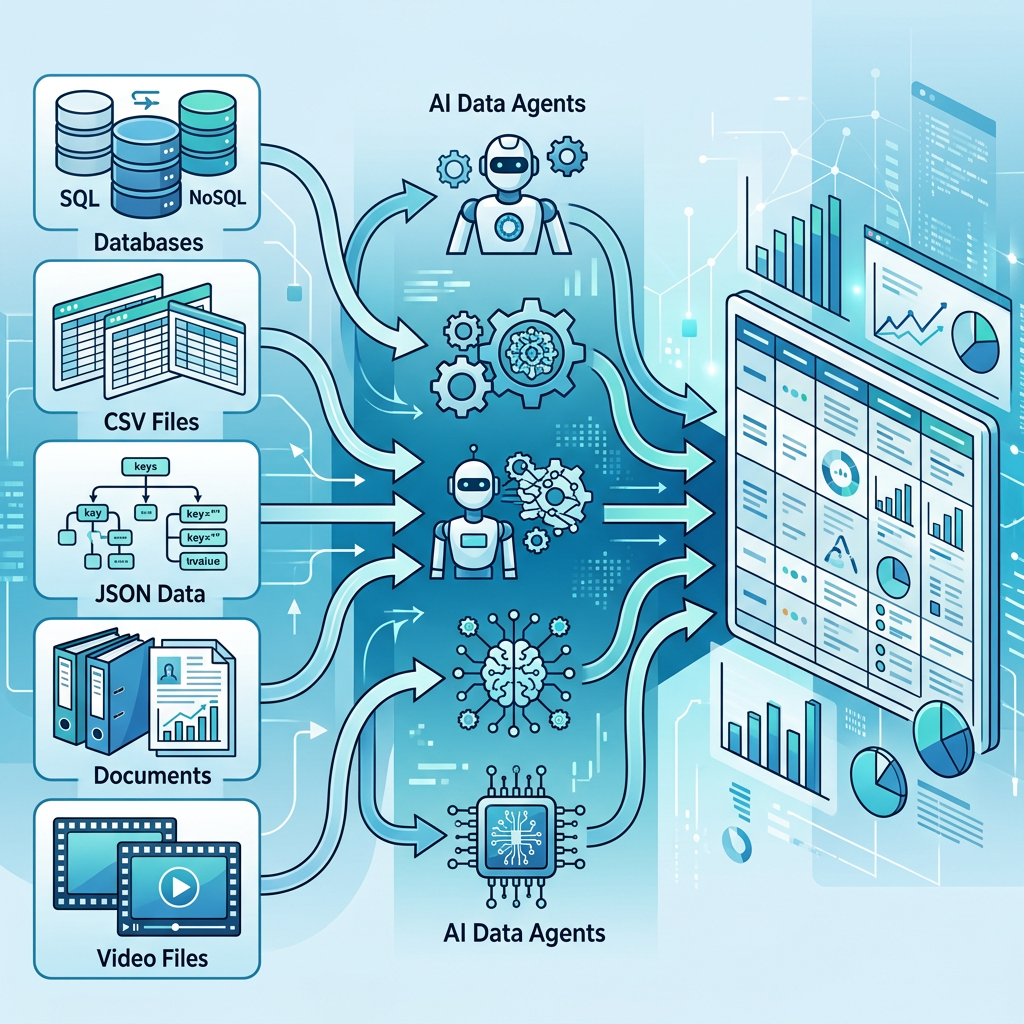
yapay zeka dunyaşinda buyuk dil modellerinin (LLM) muazzam yetenekleri her gun yeni rekorlar kiriyor, ancak yeni bir arastirma bu modellerin veri acentasi olarak guvenilir olup olmadigi konusunda onemli sorular gundeme getiriyor. DataSpace benchmark arastirmasina gore, en guclu LLM bile otomatik olarak iyi bir veri acentasi olmuyor. Bu benchmark, yapay zeka acentalarinin gercek dunya veri islemlerinde ne kadar basarili olabildigini olcmek uzere tasarlanmis olup, sonuclar sektor icin carpici uyarilar iceriyor.
DataSpace Nedir ve Neden Onemli?
DataSpace, heterojen calisma alanlari uzerinde dogrulanabilir analitik gerceklestiren veri acentalarini degerlendirmek icin gelistirilmis kapsamli bir benchmark sistemidir. Arastirmacilar, DataSpace benchmark uzerinde 410 farkli gorev test etti. Bu gorevlerde yapay zeka acentalari veritabanlari, CSV ve JSON dosyalari, uzun belgeler ile video iceriklerini birlestirerek tam olarak istenen tabloyu uretmek zorundaydi. Toplamda 7.439 artifact ve 15,01 GB veri kullanildi. Test edilen LLM’lerin en iyisi yalnizca %66,34 dogruluk oranina ulasabildi – bu, yapay zeganin kritik veri islemlerinde hâlâ cok yetersiz kaldigini gosteriyor.
Agent Harness: Model Degismez, Sadece Sistem Cercevesi Degisir
Arastirmanin en dikkat cekici bulgusu, model kalitesinin tek basina yeterli olmadigini ortaya koymasiydi. Ayni LLM modeli sabit tutulup sadece DataSpace icindeki agent harness (sistem cercevesi) degistirildiginde, dogruluk orani %30,98’den %46,34’e yukseldi. Bu 15 puanlik fark, kullanilan sistem cercevesinin (harness) performans uzerinde modelin kendisi kadar belirleyici olabilecegini kanitliyor. Baska bir deyisle, DataSpace benchmark sonuclari, veri acentasi tasariminda sadece model seciminin degil, sistem mimarisinin de kritik rol oynadigini ortaya koyuyor.
Veri Birlestirme ve Capraz Kaynak Birlestirmeleri: Kalici Zayif Noktalar
Tum test edilen modellerde tutarli sekilde gorulen zayif noktalar arasinda capraz kaynak birlestirmeleri (cross-source joins) ve farkli veri turlerini bir arada kullanma yetenegi one cikiyordu. DataSpace arastirmacilari, bu zayifliklarin multimedya kanit entegrasyonuyla birlikte tum modellerde dogruluk oranlarini dusurdugunu tespit etti. Ozellikle video iceriklerinden bilgi cikarip bu bilgiyi yapilandirilmis verilerle birlestirme gorevi, modellerin asiasi gereken en zor engellerden biri olarak belirlendi.
Hatalar Genellikle Surecin Sonunda Gerceklesiyor
DataSpace benchmark sonuclarinin bir diger carpici yonu: Hatalarin buyuk cogunlugu surecin son asamalarinda gerceklesiyor. Arastirmacilar, acentanin dogru bilgiyi buldugunu veya hesapladigini, ancak istenen sonuc tablosunu yanlis sutunlarla sundugunu gozlemledi. Bu durum, yapay zeganin veri isleme kapasitesinin yeterli olabilecegini, ancak sonuc uretimi ve sunum asamasinda ciddi aksakliklar yasadigini dusunduruyor. Error analizi, 136 Grok 4.5 hatasinin birincil nedenlerini ve evaluator semptomlarini detayli sekilde inceledi.
KDD Cup 2026 ve Gelecek Perspektifi
DataSpace, KDD Cup 2026 Data Agents for Complex Data Analysis yarismasinin resmi degerlendirme benchmarki olarak da kullanildi. Bu, arastirmanin sektorde onemli bir kilavuz niteligi tashdigini gosteriyor. Arastirmacilar, alti frontier multimodal model ve bes yaygin agent harness test ettiler. En iyi dogruluk %66,34 ile cok dusuk kaldi – bu da DataSpace benchmark‘in henz doygunluga ulasmadigini ve veri acentasi guvenilirligini artirmak icin onemli calismalar yapilmasi gerektigini ortaya koyuyor.
Sonuc: Sistem Mimarisi En Az Model Kalitesi Kadar Onemli
Bu arastirma, yapay zeka endustrisine onemli bir ders veriyor. Guclu bir LLM’ye sahip olmak, otomatik olarak guvenilir bir veri acentasi anlamina gelmiyor. DataSpace benchmark sonuclari, veri acentasi sistemlerinin tasariminda harness (sistem cercevesi) seciminin, veritabani ve capraz kaynak birlestirme yeteneklerinin, sonuc tablosu isleme mekanizmalarinin ve multimedya kanit entegrasyonunun kritik rol oynadigini kanitliyor. Gelecekteki arastirmalarin bu alanlara odaklanmasi, yapay zeka tabanli veri analitik sistemlerinin pratikte gercekten is gormesini saglayacaktir.
Kaynak: arxiv.org/abs/2608.03451
Henüz yorum yok. İlk yorumu siz yapın!