
Kısaca · 3 madde
- 1LLM Degerlendirme Krizi: Kıyaslama Sonucları Yapılandırmaya Göre Değişiyor LLM degerlendirme süreçlerinde ciddi bir metodolojik kriz ortaya …
- 2Araştırmanın en çarpıcı bulgusu şu oldu: gemma4-31b modeli, sadece yapılandırma değişikliğiyle yüzde 31 ile yüzde 89 arasında değişen başarı oranları sergiledi.
- 3Bu farklılıklar, iki ardışık modelin karşılaştırılmasında yüzde 95.7 oranında performans farkını kırılgan kalemeler oluşturuyor.
LLM Degerlendirme Krizi: Kıyaslama Sonucları Yapılandırmaya Göre Değişiyor
LLM degerlendirme süreçlerinde ciddi bir metodolojik kriz ortaya çıktı. Yeni bir araştırma, aynı büyük dil modellerinin, sadece kıyaslama koşturma yapılandırması (harness) değiştirildiğinde yüzde 31 ile yüzde 89 arasında farklı sonuçlar verebildiğini ortaya koydu. Bu bulgular, mevcut LLM sıralamalarının güvenilirliğini ciddi şekilde sorgulatıyor.
Yapılandırma Secimi Sonuclari Nasıl Etkiliyor?
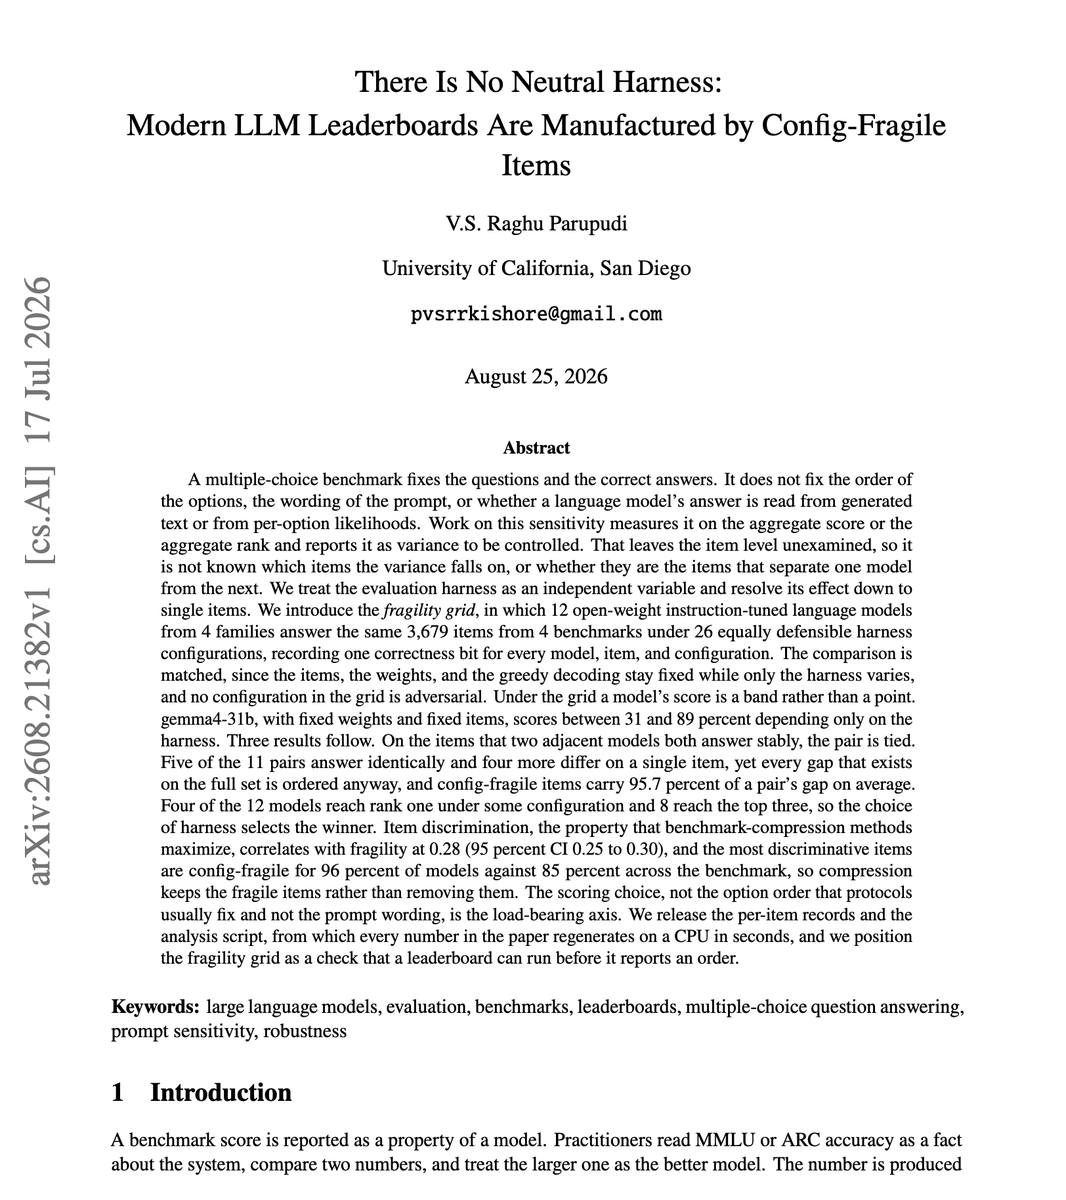
There Is No Neutral Harness başlıklı yeni araştırma, 12 farklı açık ağırlıklı modelin 3.679 soruyu 26 farklı kıyaslama yapılandırması altında değerlendirilmesini içeriyor. Çalışmada sabit tutulan unsurlar sorular, ağırlıklar ve açgözlü kod çözme oldu; sadece yapılandırma değişti.
Araştırmanın en çarpıcı bulgusu şu oldu: gemma4-31b modeli, sadece yapılandırma değişikliğiyle yüzde 31 ile yüzde 89 arasında değişen başarı oranları sergiledi. Bu, aynı modelin aynı sorulara verdiği yanıtların, nasıl değerlendirildiğine bağlı olarak dramatik şekilde değişebildiğini gösteriyor.
Kıyaslama Sonucları Gerçekten Güvenilir Mi?
Araştırmacılar, mevcut LLM değerlendirme pratiklerinin ciddi metodolojik sorunlar içerdiğini vurguluyor. Çoktan seçmeli kıyaslamalar soruları ve doğru yanıtları sabit tutsa da, seçeneklerin sırası, istem sözcüklerinin ifade biçimi ve modelin yanıtının okunma yöntemi standart değil.
Bu farklılıklar, iki ardışık modelin karşılaştırılmasında yüzde 95.7 oranında performans farkını kırılgan kalemeler oluşturuyor. Yani modeller arasındaki fark, aslında gerçek bir yetenek farkından değil, hangi soruların öne çıktığından kaynaklanıyor.
Dort Model Farklı Yapılandırmayla Birinci Olabiliyor
Araştırmanın bir diğer dikkat çekici bulgusu: Değerlendirilen 12 modelden 4ü, sadece yapılandırma değiştirilerek kendi kategorisinde birinci sıraya yerleşebiliyor. Bu durum, mevcut LLM sıralamalarının ne kadar uretilmis oldugunu gözler önüne seriyor.
Araştırma ayrıca, popüler kıyaslama sıkıştırma yöntemlerinin sorunu daha da kötüleştürdüğünü ortaya koydu. Kalem ayrımı ile kırılganlık arasında 0.28 oranında bir korelasyon tespit edildi. Sıkıştırılmış kıyaslamalar, aslında en çok yapılandırma değişikliklerinden etkilenen kalemeleri tutma eğiliminde.
Skorlama Yöntemi En Buyuk Fark Yaratan Etken
Çalışmanın en önemli sonuçlarından biri, varyansın birincil kaynağının seçenek sırası değil, skorlama yönteminin kendisi olduğunun tespit edilmesidir. Model yanıtının üretilen metinden mi yoksa seçenek olasılıklarından mı okunduğu, sonuçları en çok etkileyen faktör olarak belirlendi.
Araştırma, LLM değerlendirmesi yapan tüm profesyoneller, araştırmacılar ve model geliştiricileri için kritik uyarılar içeriyor. Kıyaslama sonuçlarını yorumlarken yapılandırma detaylarının ne kadar belirleyici olduğunun göz önünde bulundurulması gerekiyor.
Kaynak: @dair_ai | Araştırma: arxiv.org/abs/2608.21382
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/llm-degerlendirme-harnes-tercihleri/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın