
Kısaca · 3 madde
- 1Yapay Zeka Benchmark Yanıltması: Aynı Model Neden Farklı Sıralanıyor?
- 2Yeni bir araştırma, yapay zeka benchmark yanıltması konusunda endişe verici bulgular ortaya koydu.
- 3"There Is No Neutral Harness" (Nötr Bir Harness Yok) başlıklı araştırmaya göre gemma4-31b modeli, yalnızca değerlendirme konfigürasyonuna ba…
Yapay Zeka Benchmark Yanıltması: Aynı Model Neden Farklı Sıralanıyor?
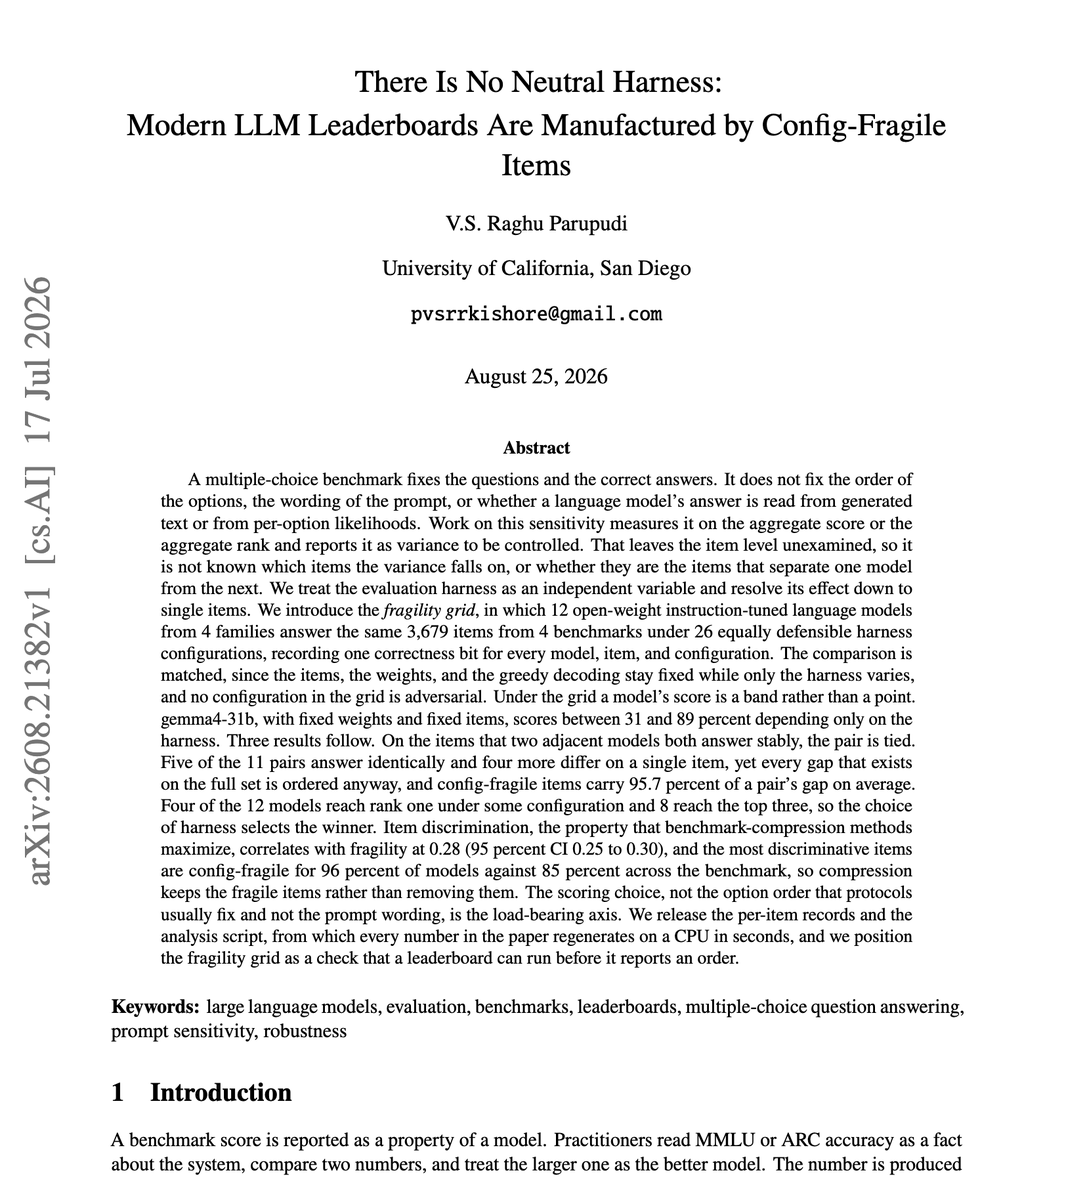
Yeni bir araştırma, yapay zeka benchmark yanıltması konusunda endişe verici bulgular ortaya koydu. On iki açık ağırlıklı yapay zeka modeli, aynı 3.679 soruluk test setini 26 farklı değerlendirme konfigürasyonunda yanıtladığında, sonuçlar yüzde 31 ile yüzde 89 arasında dramatik farklılıklar gösterdi. Bu bulgular, yapay zeka değerlendirme süreçlerinin güvenilirliğini ciddi şekilde sorguluyor.
Aynı Model, Farklı Sonuçlar
“There Is No Neutral Harness” (Nötr Bir Harness Yok) başlıklı araştırmaya göre gemma4-31b modeli, yalnızca değerlendirme konfigürasyonuna bağlı olarak yüzde 31 ile yüzde 89 arasında değişen başarı oranları sergiledi. Testler ARC, HellaSwag, MMLU ve TruthfulQA gibi standart benchmark setlerini kapsıyordu. Değiştirilen tek şey, seçenek sırası, prompt ifadesi ve yanıtın okunma yöntemiydi. Sonuçlar: aynı model, tamamen farklı performans.
Konfigürasyona Duyarlı Test Maddeleri Yüzde 95,7’si Etkiliyor
Araştırmacılar, iki bitişik modelin her ikisinin de stabil şekilde yanıtladığı sorularda modellerin birbirine bağlı çıktığını tespit etti. Ancak modeller arasındaki farkın yüzde 95,7’si konfigürasyona duyarlı sorulardan kaynaklandı. Bu durum, mevcut benchmark sistemlerinin büyük ölçüde yapay farklılıklar ürettiğini gösteriyor. İlginç bir şekilde, 12 modelden dördü en az bir konfigürasyonda birinci sıraya yerleşmeyi başardı.
Bu bulgu, “en iyi model” tanımının hangi harness’ın kullanıldığına bağlı olarak tamamen değişebildiğini ortaya koyuyor.
Benchmark Sıkıştırma Yöntemleri Yanlış Soruları Seçiyor
Araştırma ayrıca, benchmark sıkıştırma yöntemlerinin belirli soruları temsilci alt küme olarak seçerken aslında en kırılgan soruları tercih ettiğini ortaya koydu. Sıkıştırılmış benchmarklar, en az güvenilir sonuçları öne çıkardığı için elde edilen değerlendirmeler yanıltıcı olabiliyor.
Yapay Zeka Değerlendirme Kriterleri Sorgulanıyor
Bu araştırma, LLM değerlendirme standartlarının yeniden düşünülmesi gerektiğini ortaya koyuyor. Mevcut sistemler, belirli konfigürasyonlara göre ince ayar yapılmış gibi görünüyor ve bu durum model karşılaştırmalarını zorlaştırıyor.
Uzmanlar, yapay zeka değerlendirmelerinde daha tutarlı ve güvenilir metotların geliştirilmesi gerektiğini vurguluyor. Tek bir benchmark sonucuna güvenmek yerine, çoklu değerlendirme yaklaşımları gerekiyor.
Araştırma ekibi, açık ağırlıklı modeller üzerinde yapılan bu çalışmanın, tescilli model değerlendirmeleri için de önemli dersler içerdiğini belirtiyor. Yapay zeka endüstrisi, güvenilir ve tutarlı değerlendirme standartları geliştirmek için daha fazla çaba göstermek zorunda.
yapay zeka araştırma, Stanford AI, DAIR.AI ve LLM değerlendirmesi hakkında daha fazla içerik için aihaber.org‘u takip etmeye devam edin.
Kaynak: @dair_ai | Araştırma: https://t.co/CE6dCkLc80
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/yapay-zeka-benchmark-yaniltmasi-ayni-model-neden-farkli-siralaniyor/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın