
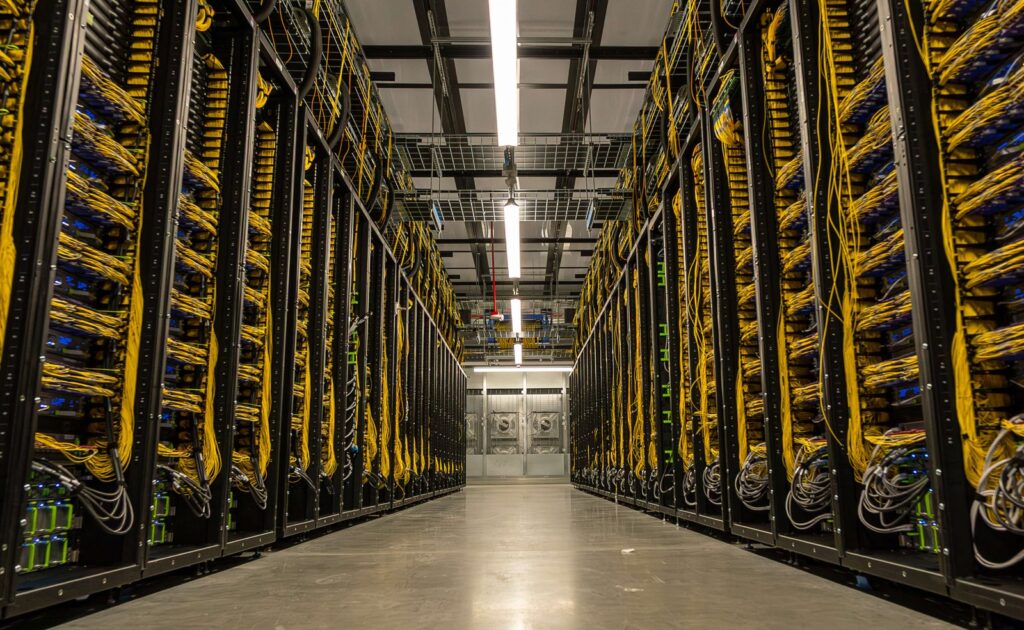
Meta Engineering, 19 Ekim’de yayımladığı yazıda şirketin Ohio eyaletinin New Albany kentindeki en iddialı AI altyapı projesi Prometheus‘u ayrıntılı olarak anlattı. Gigawatt ölçekli süperkümenin ilk fazı tamamlanmış durumda ve Muse temel model ailesinin, aralarında Muse Wonder‘ın da bulunduğu eğitiminde kullanıldı. Meta, kümeyi yaklaşık 1 milyon GPU‘ya ölçeklemeyi hedefliyor.
Bugünkü kapasite ve performans
Prometheus şu anda birden fazla birbirine bağlı bina boyunca yüzbinlerce GPU’dan oluşuyor; geleneksel veri merkezi binaları, AI’ye optimize edilmiş binalar ve hızlı kurulum yapıları milerce fiberle tek bir makine gibi çalışıyor. Altyapı, 72 GPU’nun aynı ağ kumaşında tek hızlandırıcı gibi davrandığı NVL72 raf mimarisi üzerine kurulu. Meta, Muse Wonder ön eğitim çalışmalarında yüzde 85’ten yüksek, pekiştirmeli öğrenme (RL) çalışmalarında yüzde 90’dan yüksek goodput (verimli çıktı oranı) elde ettiğini; kesinti arası ortalama duvar saatinin (MTBI) yaklaşık 47 bin GPU-saatten firmware düzeltmeleriyle 54 bin GPU-saatin üzerine çıktığını yazıyor.
İki nesil NVIDIA, üçüncü yolda
- Catalina (NVIDIA GB200 NVL72, Ariel varyantı): İki rafda 72 Blackwell GPU, GPU başına 192 GB HBM3e (toplam 13,4 TB), tepe FP8 eğitiminde 720 PFLOPS, alan içi tepe NVLink 130 TB/s, 800G ölçek dışına çıkış (GPU başına 2× ConnectX-7). Toplam sistem gücü iki raf için yaklaşık 120 kW.
- Clemente (NVIDIA GB300 NVL72): GPU başına 288 GB HBM3e (yüzde 50 daha fazla), tepe FP4 hesapta 1 exaFLOP’un üzerinde, 800G ConnectX-8 SuperNIC’ler, tek rafda 72 GPU, yaklaşık 135 kW raf gücü. Meta, GB200’e göre yüzde 5–10 performans artışı belirtiyor.
- San Miguel (NVIDIA Vera Rubin NVL72): Yakında gelecek platform; GPU başına 288 GB HBM4, tepe FP4 eğitiminde 2,52 EFLOPS, 170 kW üzerinde tamamen sıvı soğutmalı raf, GB300’e göre watt başına yüzde 10–20 iyileşme hedefi.
Ağ, güvenilirlik ve güç
Meta, standart veri merkezi ağına ek olarak GPU’lar arası doğrudan iletişim için Ethernet tabanlı Back-End (BE) ağı ve binaları 2 km’den 100 km’nin ötesine bağlayan Backend Aggregation (BAG) omurgasını kullanıyor. Bina düzeyi kumaşlar 20.736 GPU’ya kadar bağlanabiliyor. Güvenilirlikte başlangıçta günde 8 bin GPU başına neredeyse 1.000 kesintiye ulaşan oranlar, bir yıllık mühendislik çalışmasıyla yüzde 99 azaltılmış; hedefin günde iki kesinti (yaklaşık 100 bin GPU-saat MTBI) olduğu belirtiliyor. Güç yönetiminde Dynamo Dimmer çerçevesi, küme elektrik tavanına yaklaşırken GPU güç sınırlarını kademeli olarak ayarlayarak eğitimin kesilmeden sürmesini sağlıyor. Soğutmada modüler hava destekli sıvı soğutma (AALC) ve yeni AI binalarında tesis sıvı soğutması (FLC) birlikte kullanılıyor; Meta, kapalı döngü sıvı soğutmanın suyu verimli kullandığını vurguluyor.
Prometheus’tan öğrenilenler, Louisiana Richland Parish’teki gelecek süperküme Hyperion‘un tasarımına aktarılıyor.
Henüz yorum yok. İlk yorumu siz yapın!