
Microsoft Research Asia, yapay zekâ ajanlarını pekiştirmeli öğrenmeyle (RL) eğitmek için yeniden yazılmış Agent Lightning v1.0’ı açık kaynak olarak yayınladı. Araştırmacılar bununla birlikte “Harnessed Agentic RL” adını verdikleri bir eğitim yaklaşımı tanımlıyor. Bu yaklaşımda ajan, sahada hangi düzenekle (harness) çalışıyorsa eğitime de doğrudan o düzenekle katılıyor. Böylece ajanın eğitim çerçevesi içinde yeniden yazılması gerekmiyor.
Sorun: eğitilen ajan, kullanılan ajan değil
Bugünün ajanları tek bir modelden ibaret değil. Modeller, araçlar ve çalışma ortamları, bunları dışarıdan yöneten bir düzenekle birleşiyor. Geleneksel RL çerçeveleri, yani verl, AReaL ve slime gibi erken sistemler, ortamla etkileşim döngüsünün eğitim çerçevesine ait olduğunu varsayıyordu. Bu yüzden bir ajanı eğitmek, döngüsünü RL çerçevesinin içinde yeniden kurmayı gerektiriyordu. Microsoft’a göre mini-SWE-agent, OpenHands, OpenCode, Claude Code ve Codex gibi kodlama ajanlarının her biri kendi bağlam yönetimini, araç protokollerini ve bağımlılıklarını getiriyor. Bunları eğitim için yeniden kurmak pahalı. Üstelik yeniden kurulan ajan, sahadaki ajanla aynı davranmayabiliyor.
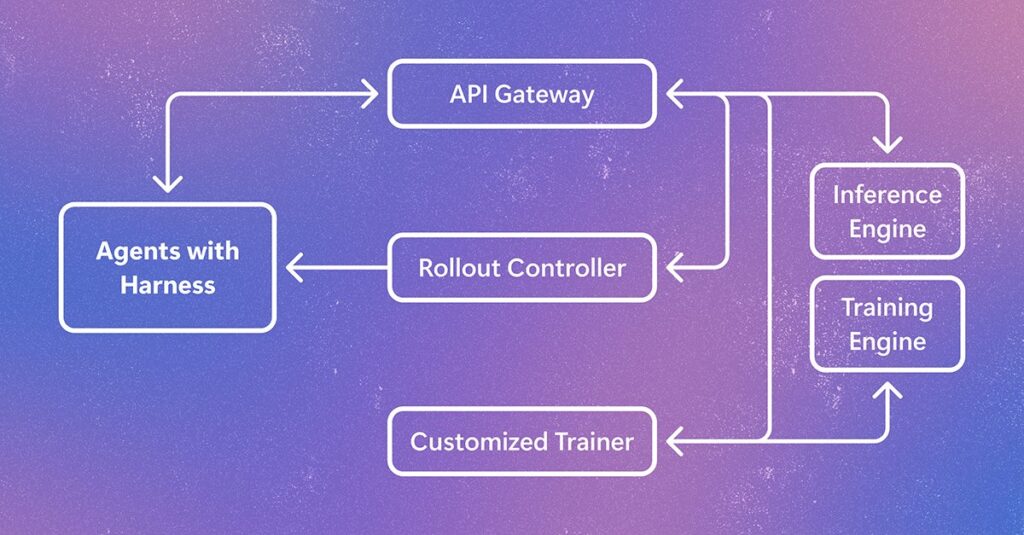
Agent Lightning bu sorunu ajan ile model arasına bir LLM proxy’si koyarak çözüyor. Ajan eskisi gibi çalışmaya devam ediyor. Model API’sini çağıran uç nokta Agent Lightning’e yönlendirildiğinde eğitim çerçevesi tüm model çağrılarını görüp kaydedebiliyor.
3.500 satırlık kontrol düzlemi
Çerçevenin tamamı yaklaşık 3.500 satır koddan oluşuyor ve üç ana bileşeni var. API Gateway, OpenAI uyumlu bir LLM proxy’si olarak çalışıyor ve her model çağrısını ilgili denemeye (rollout) bağlayarak istemleri, yanıtları ve log olasılıklarını kaydediyor. Rollout Controller, ajanları yerel süreçler ya da standart Kubernetes işleri olarak başlatıp yönetiyor. verl üzerine kurulu Customized Trainer ise örnekleri toplayıp eğitim verisine dönüştürüyor.
Gerçek düzenekle eğitim dört teknik zorluk getiriyor: metnin yeniden tokenlaştırılması ve örneklerin birleştirilmesi, avantaj hesabı, kayıp normalizasyonu ve değişken iş yükünün sabit GPU kaynaklarına yerleştirilmesi. Araştırmacılar, avantaj ve normalizasyonu örnek düzeyi yerine deneme (rollout) düzeyinde hesaplamanın daha yüksek doğrulama ödülü ve daha kararlı bir politika entropisi verdiğini bildiriyor.
Aynı GPU’da eşzamansız RL ve Kubernetes
v1.0, “Collocated Async RL” adlı bir yöntemle deneme ve model güncellemesini aynı GPU’ları paylaşarak yapıyor. Yeterli deneme toplandığında gateway yeni istekleri durduruyor, devam edenlerin bitmesini bekliyor ve güncelleme bitince denemeleri yeniden başlatıyor. Bu geçiş dışarıdaki ajan düzeneği için görünmez. Deneylerde yöntem, eşzamanlı RL’ye göre uçtan uca yaklaşık 2 kat hız sağladı ve klasik eşzamansız RL’den daha az GPU kullandı. Ajanlar Modal Sandbox veya E2B gibi ticari sandbox hizmetleri yerine standart Kubernetes işleri olarak çalışıyor. Bu da şirket içi kümelerin, bulut Kubernetes’in ya da yerel altyapının kullanılmasına imkân veriyor.
6.000 örnekle 14,6 puanlık artış
Ekip yöntemi SWE-smith, mini-SWE-agent ve Qwen3.5-9B ile kurulan uçtan uca bir kodlama ajanı hattında test etti. Hat veri temizleme, ortam kurulumu, ödül istismarına karşı önlemler ve RL eğitimini kapsıyor. Açık veri setine dayanan yaklaşık 6.000 eğitim örneğiyle yapılan RL eğitimi, modelin SWE-bench Verified’daki Pass@1 skorunu yüzde 41,8’den yüzde 56,4’e çıkardı. Bu 14,6 puanlık mutlak bir artış. Kod GitHub’da, teknik rapor ise Microsoft Research sitesinde yayımlandı.
Kaynak: Microsoft Research Blog — Agent Lightning v1.0; GitHub — microsoft/agent-lightning
Henüz yorum yok. İlk yorumu siz yapın!