
Kısaca · 3 madde
- 1Microsoft araştırmacıları, standart denetimli ince ayar (SFT) boru hattının gerçekte üretmek istediğimiz modeli mi yoksa sadece eğitim veril…
- 2Geleneksel SFT, modelin zaten öğrenmiş olduğu diziler üzerinde de gradyan harcamaya devam ediyor.
- 3OLMo-3 7B modelinde TailSFT uygulandığında, kodlama görevlerinde pass@16 performansı 16,8 puan, matematik görevlerinde ise 3,1 puan artış gösterdi.
araştırmacıları, standart denetimli ince ayar (SFT) boru hattının gerçekte üretmek istediğimiz modeli mi yoksa sadece eğitim verilerine aşırı uyum sağlamış bir modeli mi verdiğini sorguluyor. Yanıtları: Hayır.
TailSFT: Sorunu Çözmek için Basit ama Etkili Bir Yöntem
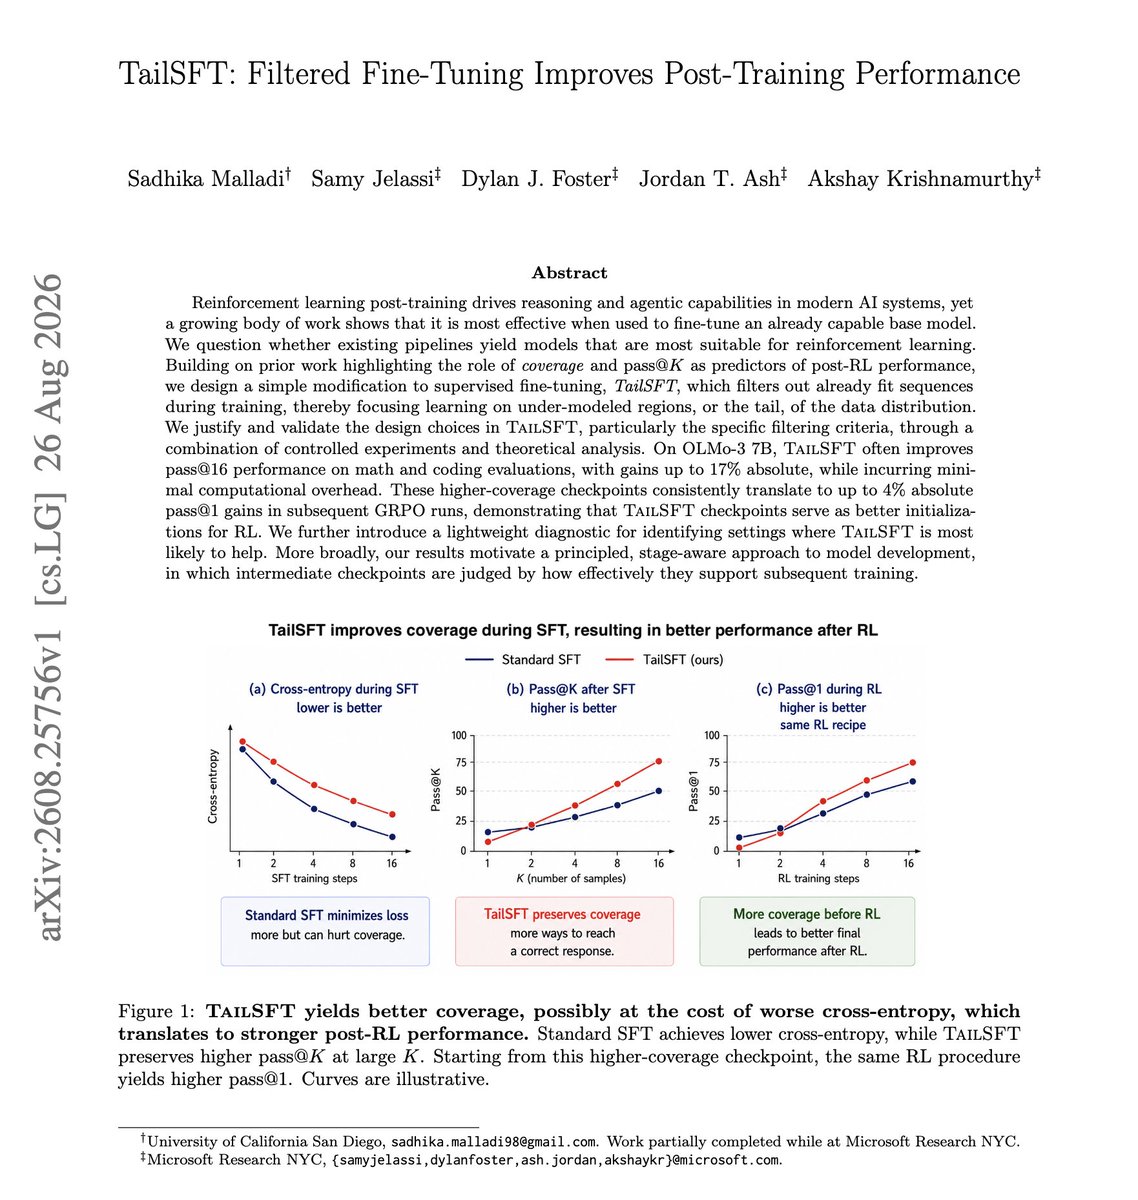
Geleneksel SFT, modelin zaten öğrenmiş olduğu diziler üzerinde de gradyan harcamaya devam ediyor. Bu da sonrasında uygulanan pekiştirmeli öğrenmenin (RL) keşfetmesi gereken dağılımı daraltıyor. TailSFT, eğitim sırasında bu dizileri filtreleyerek öğrenmenin modelin yeterince temsil edilmemiş bölgelerine yoğunlaşmasını sağlıyor.
Dikkat Çekici Sonuçlar
OLMo-3 7B modelinde TailSFT uygulandığında, kodlama görevlerinde pass@16 performansı 16,8 puan, matematik görevlerinde ise 3,1 puan artış gösterdi. Bu yüksek kapsamlı kontrol noktaları, ardından gelen GRPO çalışmalarında final pass@1’de 4 puana kadar kazanç sağladı. Bazı ayarlarda erken ödül, standart SFT çalışmasına kıyasla 2,5 kat daha hızlı yükseldi.
Nasıl Àalışıyor?
TailSFT’nin temel değişikliği oldukça basit: Eğitim sırasında modelin zaten iyi öğrenmiş olduğu dizileri çıkarmak. Böylece model, veri dağılımının “kuyruk” bölgesinde kalan daha zor ve az örneklenmiş görevlere odaklanıyor.
Bu yaklaşım, model geliştirmede aşamaya duyarlı (stage-aware) bir felsefeyi destekliyor. Araştırmacılar, ara kontrol noktalarının değerlendirilmesinde yalnızca mevcut performansın değil, bir sonraki eğitim aşamasını ne kadar desteklediğinin de ölçülmesi gerektiğini vurguluyor.
Sektör Àçısından Önemi
Bu araştırma, yapay zekâ model geliştirme süreçlerinde ince ayrıntıların ne kadar belirleyici olabileceğini gösteriyor. Standart bir boru hattında yapılan küçük bir değişlik, takviyeli öğrenmenin etkinliğini önemli ölçüde artırabiliyor.
’un bu çalışması, pekiştirmeli öğrenme öncesi temel model hazırlığının gelecekte çok daha sistematik ve veri odaklı bir şekilde yapılacağının sinyallerini veriyor.
Kaynak: DAIR.AI / X | Araştırma Makalesi (arXiv)
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/microsoft-tailsft-arastirmasi-sftde-filtreleme-yontemiyle-simdiye-kadar-en-yuksek-basari/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın