


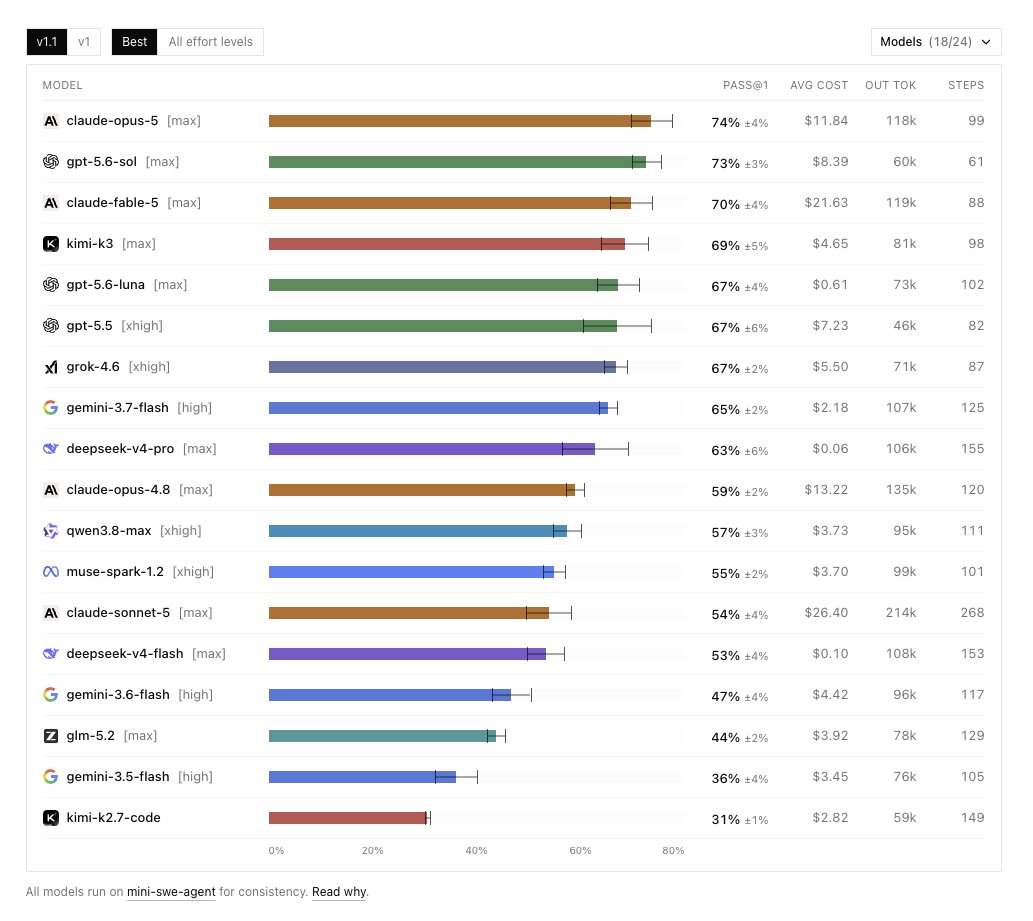

Ne? Qwen 3.6 27B modeli, yerel çalıştırma konusunda şaşırtıcı bir başarıya imza attı. Qwen 3.6 27B, yapay zeka model dünyasında önemli bir dönüm noktasına işaret ediyor. DeepSWE benchmark testinde elde edilen 42.2 skor, Qwen 3.6 27B'nin kodlama ile ilgili görevlerde 74.3B parametreli GLM 5.2 modeline yaklaştığını gösteriyor.
- Ne? Qwen 3.6 27B modeli, yerel çalıştırma konusunda şaşırtıcı bir başarıya imza attı.
- Qwen 3.6 27B, yapay zeka model dünyasında önemli bir dönüm noktasına işaret ediyor.
- DeepSWE benchmark testinde elde edilen 42.2 skor, Qwen 3.6 27B'nin kodlama ile ilgili görevlerde 74.3B parametreli GLM 5.2 modeline yaklaştığını gösteriyor.
Ne? Qwen 3.6 27B modeli, yerel çalıştırma konusunda şaşırtıcı bir başarıya imza attı.
Ne? Qwen 3.6 27B modeli, yerel çalıştırma konusunda şaşırtıcı bir başarıya imza attı. Nerede? X platformu üzerinde AI analisti @LLMJunky tarafından benchmark sonuçları paylaşıldı. Ne zaman? 14 Ağustos 2026 tarihinde sonuçlar kamuoyu ile paylaşıldı. Nasıl? Model, DeepSWE benchmark testinde 42.2 skor elde etti. Neden? Bu skor, 27B parametreli bir model için çığır açıcı bir sonuç ve çok daha büyük modellere yaklaşıyor. Kim? ’nın open source Qwen serisinin yeni modeli Qwen 3.6 27B.
Qwen 3.6 27B, yapay zeka model dünyasında önemli bir dönüm noktasına işaret ediyor. AI analisti @LLMJunky’nin paylaştığı benchmark sonuçlarına göre, bu kompakt model 42.2 DeepSWE skoru elde ederek GLM 5.2 performansına yaklaştı — ve bunu evde, kendi donanımınızda çalıştırarak başardı.
DeepSWE 42.2: 27B Model İçin Çığır Açıcı Sonuç
DeepSWE benchmark testinde elde edilen 42.2 skor, Qwen 3.6 27B’nin kodlama ile ilgili görevlerde 74.3B parametreli GLM 5.2 modeline yaklaştığını gösteriyor. Bu, 27 milyar parametreli bir model için son derece etkileyici bir performans.
@LLMJunky’nin ifadesiyle, “Bazıları çok pedantik davranıyor ve tamamen konunun özünü kaçırıyor. Asıl mesele şu ki birçok görev için, özellikle gerçek iş yapmakta kullanışlı görevler için, bu modele gerçekten çok yaklaşabilirsiniz. Evde. Kendi donanımınızda. Bu harika bir şey!”
Neden Bu Kadar Önemli?
Geleneksel olarak, en güçlü AI modelleri yalnızca bulut tabanlı API’ler üzerinden erişilebilir durumda. Ancak Qwen 3.6 27B gibi kompakt ama güçlü modeller, kullanıcıların kendi donanımlarında — evlerinde veya ofislerinde — çalıştırabilecekleri bir alternatif sunuyor.
Bu yaklaşımın avantajları:
- Maliyet Tasarrufu: API başına ödeme yerine tek seferlik donanım yatırımı
- Gizlilik: Verileriniz kendi sunucularınızda kalır
- Erişilebilirlik: İnternet bağlantısı olmadan da AI çalıştırma imkanı
- Özelleştirme: Modeli kendi verilerinizle ince ayar yapma esnekliği
Küçük Modeller İçin Yeni Çığır
Qwen 3.6 27B’nin başarısı, yapay zeka araştırmalarında “küçük ama akıllı” paradigmasının güçlenmesine katkı sağlıyor. Model, en zorlu mühendislik görevleri için Opus 4.6 gibi en üst düzey modellerin yerini alamasa da, çoğu pratik görev için tatmin edici sonuçlar sunuyor.
@LLMJunky’nin vurguladığı gibi, “En zorlu mühendislik görevleriniz için mi kullanacaksınız? Hayır, elbette değil. Ama bu modeli kullanacağınız görevler için de harika sonuç verecek.”
Teknik Detaylar ve Performans Analizi
Qwen 3.6 27B’nin 42.2 DeepSWE skoru, özellikle kodlama ve yazılım mühendisliği görevlerinde güçlü bir yetkinlik sergilediğini ortaya koyuyor. Model, Qwen 3.0 serisinin 8B versiyonlarının sunduğu yetenekleri önemli ölçüde aşarak, open source dünyasında kendi segmentinin en iyisi konumuna yerleşti.
Bu sonuçlar, Qwen 3.6 27B’nin hem araştırma hem de üretim ortamlarında ciddi bir seçenek olduğunu gösteriyor. Özellikle sınırlı bütçeye sahip girişimciler, bağımsız geliştiriciler ve gizlilik konusunda hassas kurumlar için ideal bir çözüm sunuyor.
Daha fazla benchmark karşılaştırması için yapay zeka model fiyatları 2026 ve LLM fiyat karşılaştırma sayfalarımızı inceleyebilirsiniz. Ayrıca Qwen3 8×27B modeli hakkındaki haberimiz de ilginizi çekebilir.
Qwen 3.6 27B’nin bu başarısı, open source AI modellerinin performans açığını kapatma konusundaki hızını bir kez daha ortaya koyuyor. Yerel AI çalıştırma furyası, bu model ile yeni bir boyut kazanmış görünüyor.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/qwen-36-27b-yerel-calistirma-glm-52-performans/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.


Yorum yazın