



Terminal-Bench 3.0 benchmark sonuclari aciklandi. Ne: Terminal-Bench 3.0 yapay zeka modeli karsilastirma testi sonuclari aciklandi.Ne Zaman: 11 Agustos 2026 tarihinde sonuclar paylasildi.Kim…
- Terminal-Bench 3.0 benchmark sonuclari aciklandi.
- Ne: Terminal-Bench 3.0 yapay zeka modeli karsilastirma testi sonuclari aciklandi.Ne Zaman: 11 Agustos 2026 tarihinde sonuclar paylasildi.Kim…
Terminal-Bench 3.0 benchmark sonuclari aciklandi.
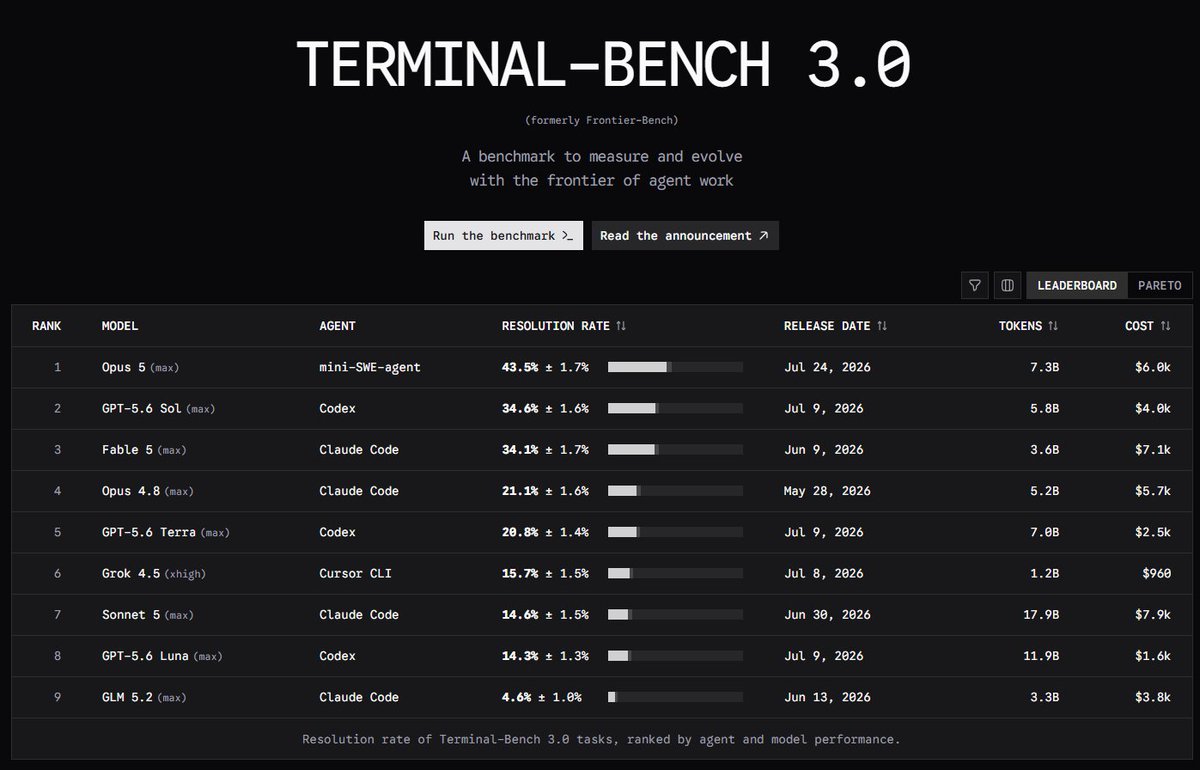
Terminal-Bench 3.0 benchmark sonuclari aciklandi. Yapay zeka dunyaunda buyuk yanki uyandiran bu yeni benchmark testinde Max, yuzde 43.5 oraniyla zirveye yerleserek birinci oldu. Bu sonuc, daha once zirvede bulunan ‘un yuzde 34.6’lik performansini geride birakti.
Ne: Terminal-Bench 3.0 yapay zeka modeli karsilastirma testi sonuclari aciklandi.
Ne Zaman: 11 Agustos 2026 tarihinde sonuclar paylasildi.
Kim: Claude Opus 5 Max (), GPT-5.6 Sol (), Fable 5.
Nerede: Terminal-Bench resmi sonuclari uzerinden tum AI topluluguna duyuruldu.
Neden: Yapay zeka modellerinin gercek dunya performansini olcmek ve karsilastirmak icin.
Nasil: Standartlastirilmis terminal ve komut satiri gorenleri uzerinden yapilan benchmark testleriyle.
Terminal-Bench 3.0 Nedir?
Terminal-Bench 3.0, yapay zeka modellerinin terminal ortamindaki performansini olcen kapsamli bir benchmark sistemidir. Bu test, modellerin gercek komut satiri gorevlerindeki yeteneklerini, kod yazma becerilerini ve sistem yonetimi kabiliyetlerini degerlendiriyor.
Claude Opus 5 Max Zirvede: Yuzde 43.5 ile Rekor
Claude Opus 5 Max, Terminal-Bench 3.0’da elde ettigi yuzde 43.5’lik skorla yeni lider konumuna yukseldi. Bu sonuc, Anthropic’in modelinin OpenAI’in GPT-5.6 Sol modeline karsi onemli bir ustunluk sagladigini gosteriyor.
GPT-5.6 Sol Geride Kaldi: Performans Analizi
GPT-5.6 Sol, yuzde 34.6’lik skorla ikinci sirada yer aldi. OpenAI’in bu modeli, ozellikle uzun sureli gorevlerde ve karmasik karar alma sureclerinde Claude Opus 5 Max’in gerisinde kaldi. Analistler, bu farkin buyuk dil modellerinin gercek dunya uygulamalarindaki etkinligini sorgulatacak boyuta ulastigini belirtiyor.
Fable 5 Ucuncu Sirada: Sonuclar Ne Anlama Geliyor?
Fable 5, yuzde 34.1’lik skoruyla ucuncu sirada yer aldi. Fable’in performansi, GPT-5.6 Sol’un hata payi icinde kal masi nedeniyle dikkat cekici. Bu durum, ust duzey AI modelleri arasindaki rekabetin ne denli cekismeli gectigini gosteriyor.
Benchmark Sonuclari Yapay Zeka Modelleri Icin Neden Onemli?
Terminal-Bench 3.0 sonuclari, yapay zeka modellerinin pratik kullanimdaki gercek performansini ortaya koyuyor. Claude Opus 5 Max‘in zirveye yerlesmesi, Anthropic’in model gelistirme stratejisinde onemli bir adim oldugunu gosteriyor. Rakiplerinin OpenAI ve diger gelistiricilerin bu sonuclara nasil tepki verecegi merak konusu.
Kaynak: @synthwavedd / X
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/terminal-bench-3-claude-opus-5-max-benchmark/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.


Yorum yazın