
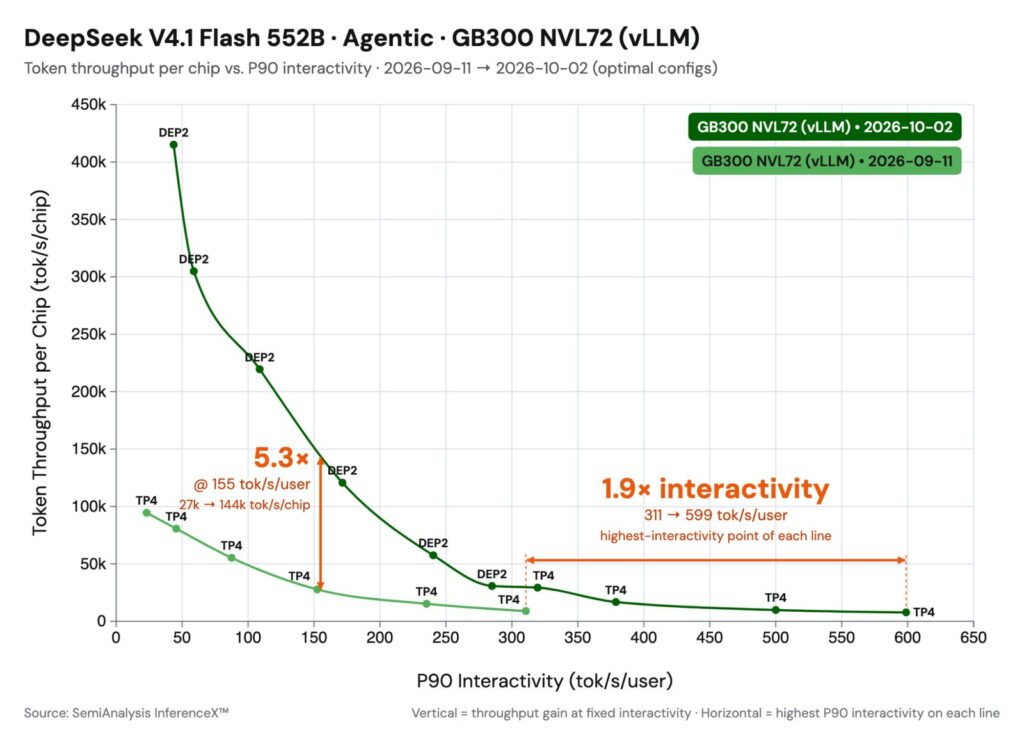
Açık kaynak çıkarım motoru vLLM, Çinli yapay zekâ şirketi DeepSeek’in DeepSeek-V4.1-Flash modelinde ilk günkü desteğe göre büyük bir performans artışı elde ettiğini duyurdu. vLLM blogundaki yazıya göre modelin yayınlanmasının ardından geçen üç haftada Inferact ekibi ve vLLM topluluğu, düşük eşzamanlılıkta 1,9 kat hızlanma ve saniyede 150 token (TPS) kısıtı altında 5,3 kat verim artışı sağladı. Ölçümler SemiAnalysis’in ajan tabanlı sunum testi AgentX ile yapıldı.
Modelin mimarisi
vLLM’in aktardığına göre DeepSeek V4.1, uzun soluklu ajan işleri için verimli bir mimari kullanıyor. Nedensel kodlayıcı-kod çözücü (CED) yapısı sayesinde model, çözümleme sırasında token başına 16 milyar, ön doldurma (prefill) sırasında ise yalnızca 8 milyar parametreyi etkinleştiriyor. KV önbelleğini küçültmek için Compressed Sparse Attention 2 (CSA2), FP4 KV önbelleği ve katmanlar arası KV paylaşımı birlikte kullanılıyor. Böylece genel KV ayak izi token başına 890 bayta iniyor.
SWA bounded replay
Model iki tür KV önbelleği tutuyor: sıkıştırılmış ve FP4’te saklanan genel KV ile 40 katmanın her birinde son 128 pozisyonu kapsayan, FP8’deki sıkıştırılmamış kayan pencere (SWA) KV. SWA önbelleği, önek önbelleklemede genel KV’nin 10 katından fazla depolama gerektiriyor. DeepSeek V4.1, bunu çözmek için “SWA bounded replay” yöntemini getiriyor. Yöntem pencereyi tam olarak yeniden hesaplamak yerine yalnızca son 128 tokenı yeniden çalıştırıyor. Sonuç bit düzeyinde birebir aynı değil. DeepSeek ihmal edilebilir kalite kaybı bildiriyor. vLLM de GSM8K ve GPQA gibi testlerde anlamlı bir doğruluk farkı görmediğini söylüyor.
vLLM bu yöntemi iki yerde uyguluyor. Kodlayıcı tarafında yalnızca genel KV önbelleğe alınıyor ve önek isabetinde SWA penceresi yeniden kuruluyor. Kod çözücü tarafında 21–39. katmanlar her isteğin yalnızca son 128 tokenında çalıştırılıyor. Bu da uzun istemlerde modelin neredeyse yarısının atlanması anlamına geliyor. Kesilmiş katmanlar için ayrı CUDA graph’ları yakalandığında ön doldurma hesaplama süresi yüzde 30–40 kısalıyor.
DeepSeek’in yeni çekirdekleri
DeepSeek, modelle birlikte üç deposunda yeni çekirdekler yayımladı: DeepSeek Sparse Attention için yeni top-k kütüphanesi DeepSelect, DeepGEMM’e eklenen seyrek indeksleyici ve birleşik GEMM çekirdekleri, FlashMLA’ya eklenen NVFP4 KV önbellek desteği ve MegaAttention. vLLM bunların birçoğunu entegre etti. NVIDIA GB200’de Mega-mHC önceki TileLang sürümünden 1,14–1,51 kat hızlı. Mega-Gate orta parti boyutlarında 1,18–1,31 kat hız sağlıyor. Seyrek MQA logit çekirdeği GB300’de 512 bin tokenlık bağlamda katman başına 14–23 kat hızlı. MegaAttention’ın okuduğu NVFP4 sıkıştırılmış KV biçimi, önceki FP8 önbellekten yüzde 45 daha küçük.
Sunum ayarları
Düşük gecikme için dört GPU’ya tensör paralelliği (TP4) ve FlashInfer dikkat çekirdeği kullanıldı. Yüksek verim için ise DP dikkat ve GPU’lara dağıtılmış uzmanlarla DEP2 yapılandırmasına geçildi. vLLM, V4.1’in bellek verimliliği sayesinde test boyunca KV önbelleğini dışarı aktarmaya gerek kalmadığını belirtiyor. Yaklaşık 100 bin verim seviyesinde ilk token süresi (TTFT) yüzde 70’e yakın düştü. Ekip; DeepSeek’e modeli ve çekirdekleri açık kaynak yaptığı, NVIDIA’ya işbirliği ve SemiAnalysis’e AgentX testi için teşekkür ediyor.
Kaynak: vLLM Blog — DeepSeek-V4.1-Flash on vLLM: 5x Agentic Throughput Since Day 0
Henüz yorum yok. İlk yorumu siz yapın!