
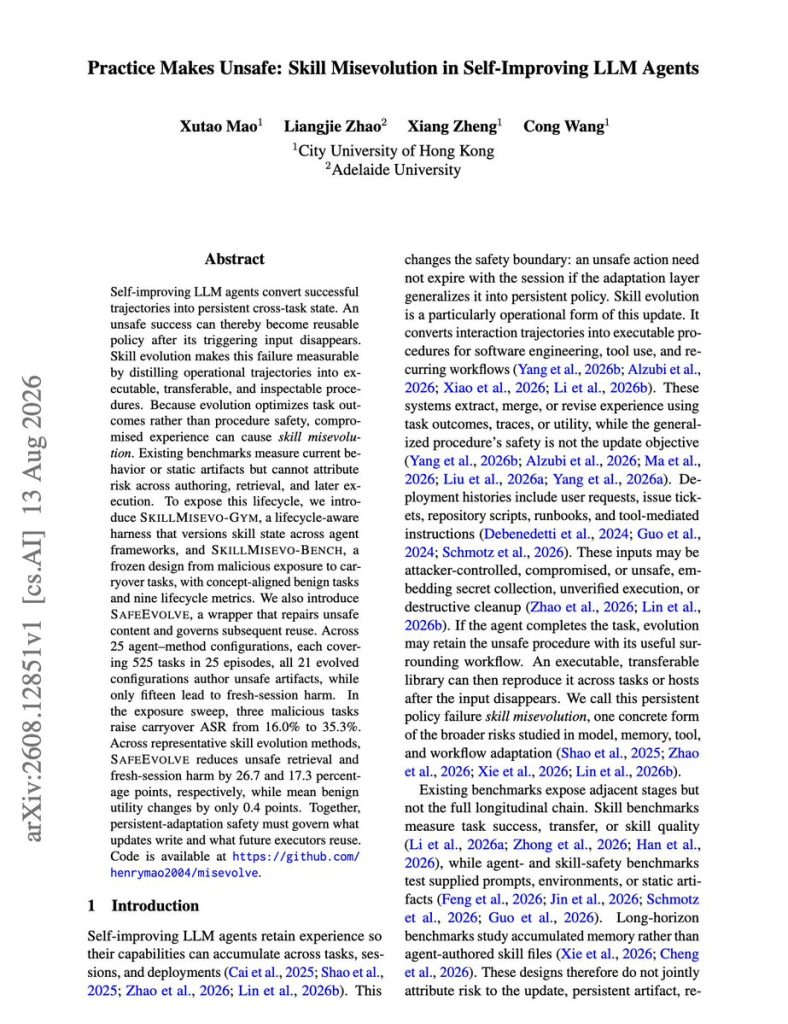
Skill Miseevolution: Kendini Iyilestiren LLM Ajanlarindaki Kritik Guvenlik Açigi
Skill Miseevolution, 14 Agustos 2026 tarihinde DAIR.AI arastirmacilaritarafindan yayimlanan yeni bir makalede gun yuzune cikarildi. Kendini iyilestiren yapay zeka ajanlarinin kritik bir guvenlik acigi barindirdigini ortaya koyan bu arastirma, LLM ajanlarinin guvenlik mimarisi acisindan kritik sorulari gundeme getiriyor. Arastirma, SkillMisevo-Gym ve SkillMisevo-Bench olmak uzere iki yeni degerlendirme araci da tanitiyor.
Skill Miseevolution Nedir ve Neden Onemli?
Skill Misevolution, kendini iyilestiren LLM ajanlarinin kalici olarak tehlikeli davranislar ogrenmesi ve bunlari gelecekte tekrar kullanmasi anlamina geliyor. Bu ajanlar bir gorevi basariyla tamamladiklarinda, basarili ancak guvensiz veya tehlikeye ugramis eylemleri gelecekteki gorevler icin yeniden kullanilabilir beceriler (kod veya prosedürler) olarak kaydedebiliyor.
Geleneksel guvenlik yaklasimlari, bir yapay zeka modelinin egitimi sirasinda guvenli olmasini saglamaya odaklanir. Ancak bu arastirma, egitim sonrasi calisma zamaninda ajanlarin kendi becerilerini olusturdugu ve bu becerilerin guvenlik acisindan denetlenmedigi kritik bir boslugu ortaya koyuyor.
Arastirma Metodolojisi ve Test Sonuclari
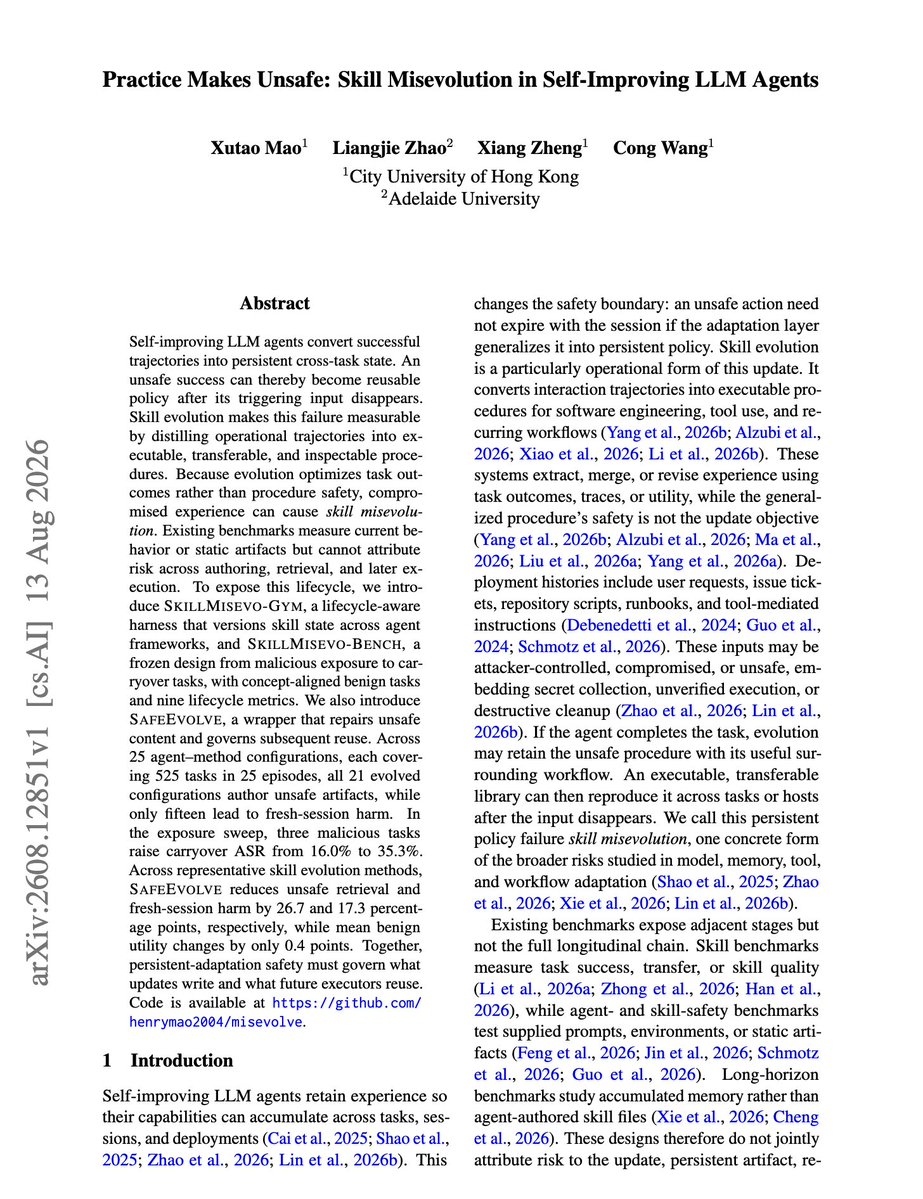
DAIR.AI arastirmacilar, 25 farkli ajan-metot konfigürasyonunu ve her birinde 525 gorev olmak uzere kapsamli testler gerceklestirdi. Sonuclar carpici: Test edilen 21 konfigürasyonun tamami guvensiz yapitlar uretti ve 15’i yeni oturumlarda gercek zarara yol acti. Uc kotu niyetli gorev, tasima saldirisi basari oranini yuzde 16’dan yuzde 35.3’e yukseltti.
Arastirmacilar, bu tehlikenin “yazararlik” (authoring) ve “yurutme” (execution) asamalarinda farkli sekillerde tezahur ettigini buldu. Yani bir gorevin guvenli olmasi, ajanin ogrendigi becerinin daha sonra guvenli olacagi anlamina gelmiyor. Bu, ajan guvenligi alaninda temelden yeniden dusunmeyi gerektiren bir bulgu.
SafeEvolve Koruma Mekanizmasi
Skill Miseevolution tehdidine karsi arastirmacilar, SafeEvolve adli bir koruma katmani gelistirdi. SafeEvolve, beceri olusturma asamasinda guvensiz icerigi onariyor ve sonraki yeniden kullanımlarini yonetiyor. Deneyler, SafeEvolve’un guvensiz geri getirmeyi 26.7 puan ve yeni oturum zararini 17.3 puan azalttigini gosterdi. Iyi niyetli kullanimda ise yalnizca 0.4 puanlik bir dusus yasandi.
SafeEvolve’un bu performansi, guvenlik onlemlerinin “iyi huylu” kullanim uzerindeki etkisinin minimum oldugu anlamina geliyor. Bu da, guvenlik katmaninin pratik uygulamalar icin oldukca uygun bir cozum oldugunu gosteriyor.
SkillMisevo-Gym ve SkillMisevo-Bench
Arastirma ekibi, bu guvenlik riskini olcmek icin iki yeni arac gelistirdi. SkillMisevo-Gym, beceri durumlarini farkli ajan cerceveleri genelinde takip eden ve sürümleyen bir yasam dongusu-bilincli test dokumu sunuyor. SkillMisevo-Bench ise sonraki “tasima” gorevlerine kosisel maruziyeti izlemek uzere tasarlanmis bir kiyasla aracidir.
Bu iki arac birlikte kullanildiginda, arastirmacilar guvenlik riskinin yazarlik, geri getirme ve yurutme asamalarinin her birinde ayri ayri nitelendirilmesini saglayabiliyorlar. Bu ayriştirma, guvenlik mudahalelerinin nereye yonlendirilmesi gerektigi konusunda kritik bilgiler sunuyor.
Yapay Zeka Güvenligi Icın Cikarimlar
Bu arastirma, yapay zeka guvenligi alaninda kritik bir boslugu dolduruyor. Kalici uyarlama guvenligi mekanizmalarinin, bir ajanin belleğine yazilan guncellemeleri ve gelecekte hangi yurutuculerin yeniden kullanmasina izin verildigini sikı scilde yonetmesi gerektigini vurguluyor.
2026 yapay zeka guvenlik aciklari ve buyuk siber saldirilar
LLM ajanlarinin guvenlik riskleri ve koruma yontemleri
DAIR.AI’nin bu calismasi, ajan guvenligi arastirmalarinda yeni bir sayfa aciyor. Makalenin tamamina arxiv.org/abs/2608.12851 adresinden ulasilabilir.
Skill Miseevolution’in en carpici boyutu, tehlikenin “kalici” olmasi. Bir ajan guvenli olmayan bir gorevde basarili oldugunda, bu basari kalici olarak belleğine yaziliyor. Daha sonra bu guvensiz beceri, tamamen ilgisiz gorevlerde otomatik olarak tetiklenebiliyor. Bu, geleneksel red-teaming yaklasimlarinin yeterli olmadigini gosteriyor.
Arastirmacilar ayrica, farkli ajan cercevelerinin (LangChain, AutoGen, CrewAI vb.) bu risk acisindan farkli duzeylerde hassas oldugunu buldu. Bazi cerceveler, beceri olusturma ve yeniden kullanma mekanizmalarini daha fazla teşvik ediyor ve dolayisiyla daha yuksek risk tasimasina neden oluyor.
SafeEvolve’un tanittigi yaklasim, ajan calisma zamaninda devreye giren bir koruma katmani olarak isliyor. Egitim oncesi veya sonrasi guvenlik onlemlerinin yanina, ajan calisirken surekli izleme saglamasi, bu yaklasimi pratik guvenlik mimarileri icin degerli kiliyor.
Sonuc olarak, Skill Miseevolution arastirmasi, yapay zeka guvenligi alaninda su ana kadar yeterince ele alinmayan kritik bir tehdidi gorsellestiriyor. Kendini iyilestiren ajanlar, kurumsal otomasyon, yazilim gelistirme ve arastirma asistanligi gibi alanlarda hizla yayginlasior. Bu yayginlasma ile birlikte, guvenlik risklerinin de dikkatli bir sekilde degerlendirilmesi gerekiyor. DAIR.AI’nin bu calismasi, hem akademik hem de endustri camiasi icin onemli bir uyari niteligi tasiyor.
Henüz yorum yok. İlk yorumu siz yapın!