
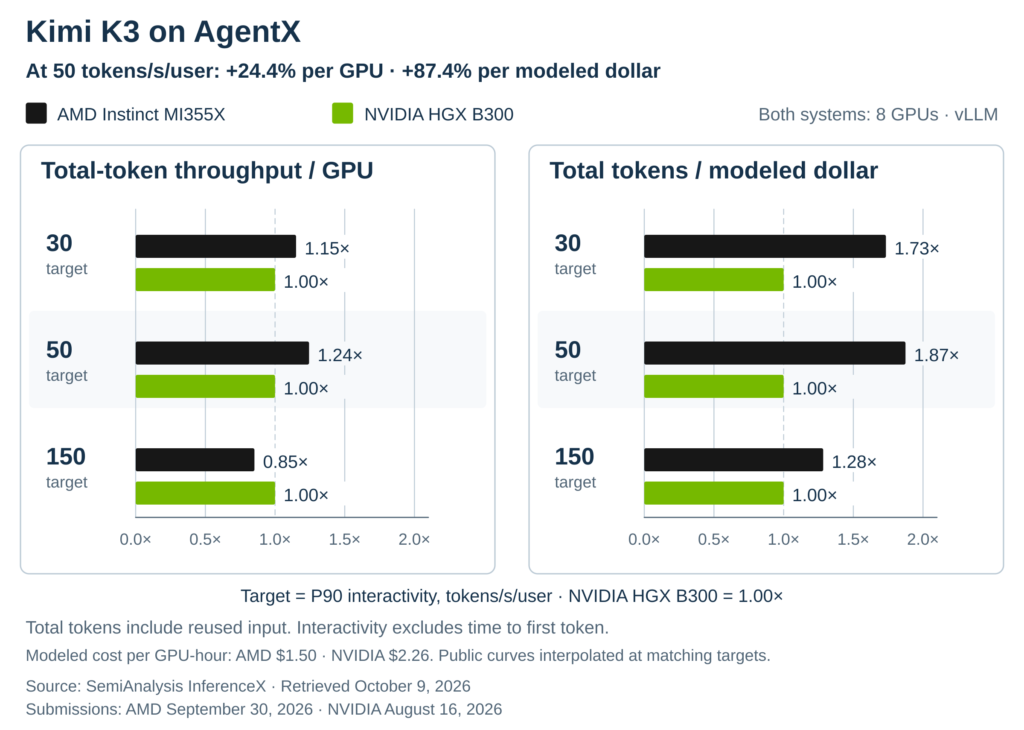
Açık kaynaklı çıkarım motoru vLLM, Moonshot’ın Kimi K3 modelini AMD Instinct MI355X GPU’ları üzerinde optimize etme çalışmasının ayrıntılarını paylaştı. Ekibe göre AgentX ajan iş yükünde, vLLM ile Kimi K3 sunan sekiz GPU’lu bir AMD Instinct MI355X sistemi, kullanıcı başına 50 token/sn (P90) etkileşim düzeyinde GPU başına NVIDIA HGX B300’den yüzde 24,4 daha fazla token üretiyor; sahip olma maliyeti modeline göre ise dolar başına yüzde 87,4 daha fazla token sunuyor.
AgentX iş yükü
Kamuya açık AgentX kıyaslaması, gerçek kodlama ajanı oturum izlerini sentetik token’larla yeniden oynatıyor; istek uzunluklarını, zamanlamayı ve önek paylaşım desenlerini koruyor. İş yükü, sınırsız önbellekle yüzde 96’nın üzerinde teorik önek yeniden kullanımı sunuyor. SemiAnalysis’in modellediği maliyete göre MI355X GPU-saati başına 1,50 dolar, B300 için 2,26 dolar alındığında; sekiz GPU’lu sistem 50 token/sn hedefinde yaklaşık 7.567 token/sn/GPU verirken B300 6.083 token/sn/GPU veriyor.
Optimizasyonlar
vLLM, kazanımın arkasındaki mühendislik kararlarını sıraladı: Kimi K3’ün 24 MLA katmanının sıkıştırılmış KV geçmişini GPU’lar arasında bölen sekiz yönlü kod çözme bağlam paralelliği (DCP8); durum GPU belleğine sığmadığında MLA geçmişini ve KDA kontrol noktalarını ana bellekte tutan CPU boşaltma; MoE katmanlarında GPU’lar arasında yinelenen çıktı projeksiyonunu ortadan kaldırma; ve belleğe bağlı işlemleri birleştiren çekirdek düzeyi iyileştirmeler. Örneğin 142 bin tokenlık bir sohbette MLA yükü GPU başına yaklaşık 1,96 GB’tan DCP8 ile yaklaşık 245 MB’a düşüyor. vLLM, bu kazanımların AMD ve topluluğun süregelen yazılım mühendisliğini yansıttığını belirtiyor.
Henüz yorum yok. İlk yorumu siz yapın!