
Kısaca · 3 madde
- 1阶跃星辰 (StepFun), StepAudio 3 serisini duyurdu: Realtime, ASR, TTS, Gen ve Music.
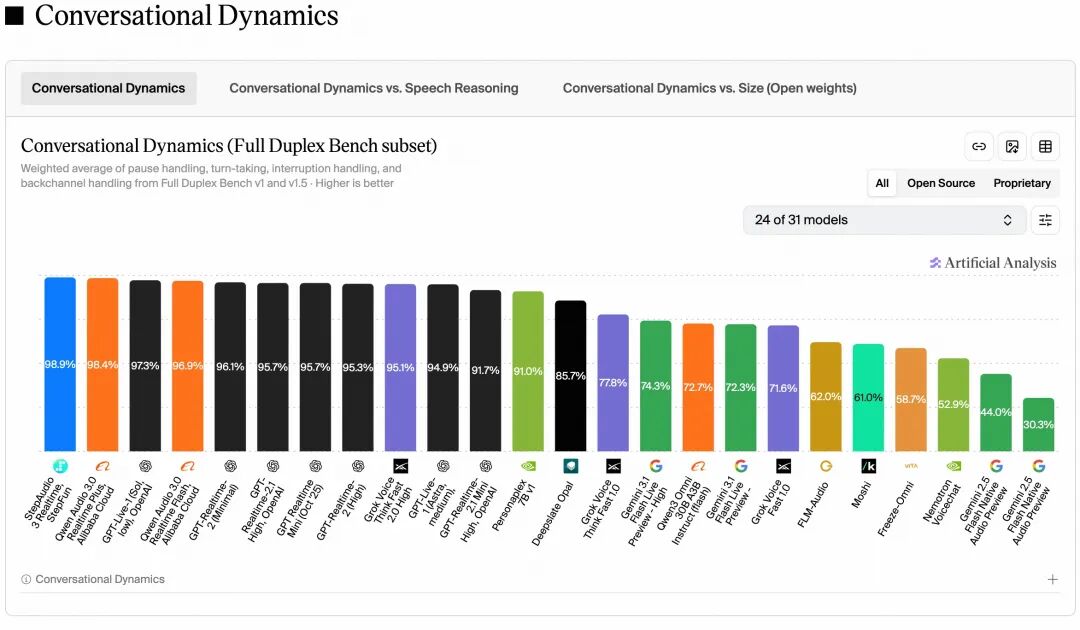
- 2StepAudio 3 Realtime Native full-duplex gerçek zamanlı konuşma sunuyor. Artificial Analysis Conversational Dynamics'te yüzde 98,9 ile birinc…
- 3ASR, TTS, Gen ve Music ASR, Çinçe/İngilizce, diyalekt, karışık dil, uzun ses ve alan terimlerinde bağlamlı tanıma hedefliyor; Artificial Ana…
阶跃星辰 (), StepAudio 3 serisini duyurdu: Realtime, ASR, TTS, Gen ve Music. Beş model de açık platformuna alındı. Şirketin aktarımına göre birden fazla model Artificial Analysis sıralamalarında birinci konumda.
StepAudio 3 Realtime
Native full-duplex gerçek zamanlı konuşma sunuyor. Artificial Analysis Conversational Dynamics’te yüzde 98,9 ile birinci; Speech Reasoning’de yüzde 99,7 ile birinci olduğu belirtiliyor. Semantik, ton, duygu, paralanguage ve ortam sesini birlikte yorumlayabildiği; Think-While-Speaking ile muhakemeyi konuşmayla paralel yürütebildiği; Tool Call ve uzun görevlerin oturumu bloke etmeden asenkron çalıştığı aktarılıyor.
ASR, TTS, Gen ve Music
ASR, Çinçe/İngilizce, diyalekt, karışık dil, uzun ses ve alan terimlerinde bağlamlı tanıma hedefliyor; Artificial Analysis non-streaming ASR’da WER yüzde 1,7 ile birinci sırayı paylaştığı yazılıyor.
TTS, gerçek zamanlı akışlı üretimle gülme, tereddüt, kekeleme gibi paralanguage unsurlarını da içeren «insan benzeri» konuşma sentezi sunuyor.
Gen, insan sesi, efekt, ortam ve müziği tek çerçevede üretebiliyor; çok karakterli diyalog ve zamanlama kontrolü vurgulanıyor.
Music, sıfırdan şarkı, a cappella eşlik, cover ve ABC notasyonlu çok turlu etkileşimli bestelemeyi destekliyor.
Kaynak: IT之家 – 阶跃发布 StepAudio 3 系列语音大模型 · Platform: platform.stepfun.com
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/stepfun-stepaudio-3-ses-modelleri/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın