
Kısaca · 3 madde
- 1Terminal-Bench 3.0, terminal tabanlı yapay zeka modellerini değerlendiren en kapsamlı benchmark çalışması olarak yayımlandı.
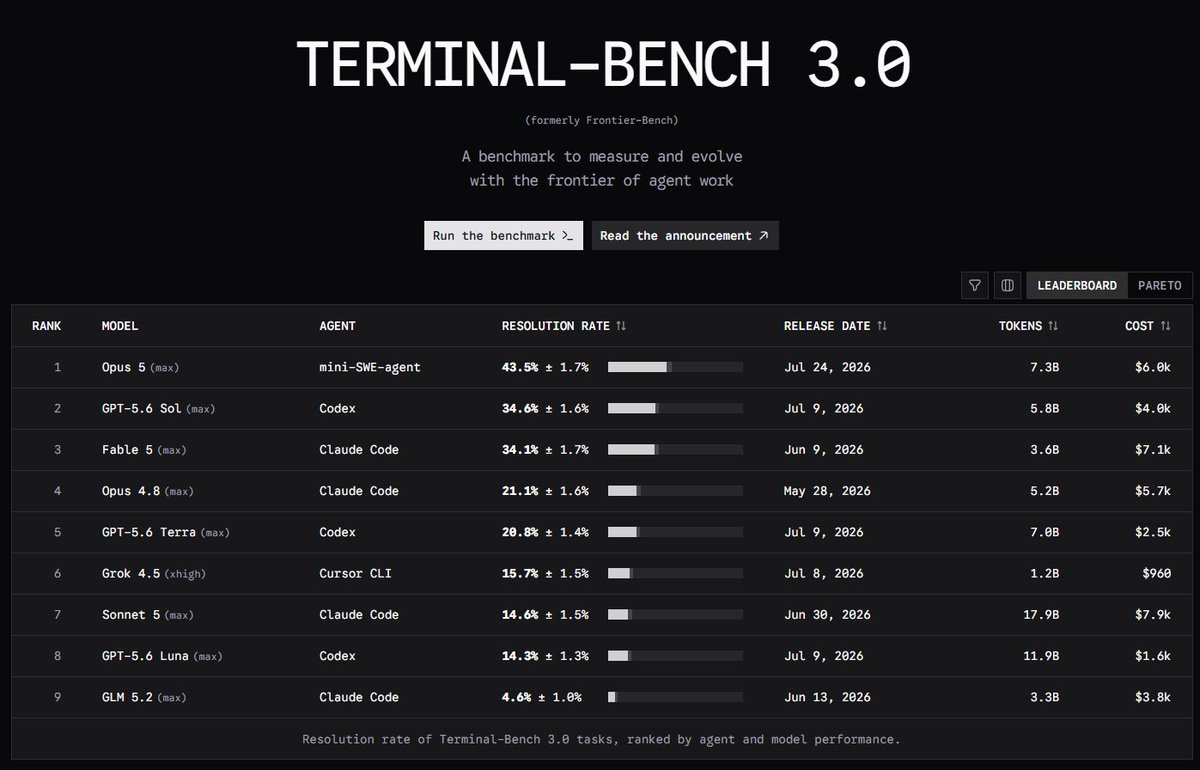
- 2Terminal-Bench 3.0 Sonuçları Terminal-Bench 3.0 benchmark'ında Claude Opus 5 Max, yüzde 43.5'lik etkileyici bir SoTA (State of the Art) skor…
- 3Claude Opus 5 Max'in Parlaması Claude Opus 5 Max, özellikle terminal ortamında çalışan kodlama ve sistem yönetimi görevlerinde üstün perform…
Terminal-Bench 3.0, terminal tabanlı yapay zeka modellerini değerlendiren en kapsamlı benchmark çalışması olarak yayımlandı. Bu yeni sürümde Max, modelini geride bırakarak zirveye oturdu. Terminal-Bench 3.0 sonuçları, yapay zeka kodlama asistanları arasındaki rekabetin ne denli kızışmış olduğunu gözler önüne seriyor.
Terminal-Bench 3.0 Sonuçları
Terminal-Bench 3.0 benchmark’ında Max, yüzde 43.5’lik etkileyici bir SoTA (State of the Art) skoru elde etti. ise yüzde 34.6’lık skorla ikinci sırada kaldı. Üçüncü sırada yer alan Fable 5, yüzde 24.1’lik skoruyla ’un hata payı içinde kalarak güçlü bir rekabet sergiledi.
Claude Opus 5 Max’in Parlaması
Max, özellikle terminal ortamında çalışan kodlama ve sistem yönetimi görevlerinde üstün performans sergiledi. Bu sonuç, ’in modelinin gerçek dünya kodlama senaryolarında ne denli etkili olduğunu bir kez daha kanıtlamış oldu.
GPT-5.6 Sol: İkinci Sırada Güçlü Rekabet
’nin modeli, yüzde 34.6’lık skorla ikinci sırada yer almasına rağmen hâlâ güçlü bir performans sergiliyor. Fable 5’in yüzde 24.1’lik skoruyla ’ün hata payı içinde kalması, üst seviye modeller arasındaki rekabetin ne kadar yakın olduğunu gösteriyor.
Terminal-Bench Neden Önemli?
Terminal-Bench 3.0, yapay zeka modellerini gerçek terminal komutları ve görevleri üzerinden test eden nadir benchmark’lardan biri. Bu test, modellerin yalnızca kod yazma değil, aynı zamanda terminal komutlarını anlama, hata ayıklama ve sistem yönetimi konusundaki gerçek dünya yeteneklerini ölçüyor.
Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/terminal-bench-3-claude-opus-5-max-zirvede/
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın