
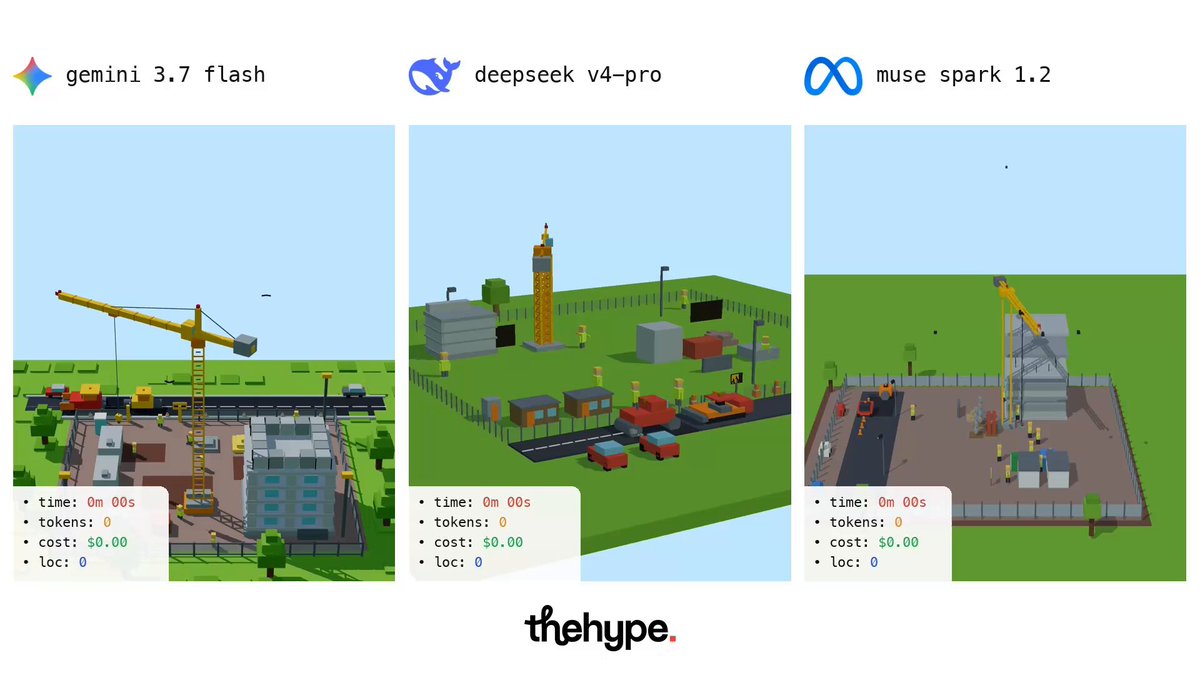
Test Kurulumu: Uc Yapay Zeka Modeli Ayni Kosullarda Karsilastirildi
Yapay zeka kodlama testi, @thehypedotnews tarafindan ’in Hermes Agent CLI uzerinden OpenRouter ile gerceklestirildi. Her uc modele — DeepMind , ve — ayni Three.js r185 kosullari ve dort tus duzeni (isin, zemin, kavsak, gece modu) verildi. Her sahne tek dosya, buildsiz, varliksiz calisti.Derleme Suresi: Muse ve Gemini Dakikalarda Bitirdi, DeepSeek 91 Dakika Harciyor
Uc modelin performanslari dramatik farklarla ayrisiyor. 6 dakika 43 saniyede, ise 7 dakika 20 saniyede uc sahneyi de tamamladi. Buna karsin sahne basina 15 ila 41 dakika arasinda sure harciyordu; toplamda 91 dakika 25 saniye surdu.Token Tuketimi: 48 Kat Fark ve Ajan Cagri Dongusu
Token sayilari tam bir basarisizlik tablosu ciziyor. toplam 440.279 token kullandiginda, 713.855 token tuketti. V4 Pro ise inanilmaz 20.957.568 token yakti — Muse’in 48 kati, Gemini’nin 29 kati kadar. Ajan cagrisi sayisinda da benzer bir tablo var: Muse 12, Gemini 18 cagri yaparken 143 cagri gerceklestirdi.Maliyet Analizi: Prompt On Belleme Aldatmasi
Toplam fatura acisindan 0,53 dolarla birinci, 0,56 dolarla ikinci, V4 Pro ise 4,57 dolarla sonuncu oldu. Ancak burada onemli bir nokta var: ’in 4,57 dolarlik faturasi, yaklasik 30 dolarlik yeniden gonderilen icerigi absorbe eden prompt caching indirimi sayesinde bu kadar dusuk kaldi. Billing gozuksun diye yapay zeka kodlama maliyetini dusurebilir; ancak gecikme ve yeniden deneme yuku ortadan kalkmiyor.Kod Kalitesi ve Ajan Verimliligi
Muse, uc sahnenin ikisini kazandi ve en kucuk dosyalari uretti: 887 ila 1.042 satir. Gemini’nin dosyalari 1.934 ila 2.377 satirdi. ’in dosyalari suresine gore beklenenden az buyuk olmasa da 143 cagri dongusu ve surekli dosya yeniden acma, kucuk bir derlemeyi devasa bir inference dongusune donusturdu.Sonuclardan Cikarilan Ders: Yapay Zeka Ajan Verimliligi Neden Onemli?
Bu test, yapay zeka kodlama ajanlarinda cevaba ulasma hizi ile cevabin kendisi kadar onemli oldugunu gosteriyor. Bir modelin surekli dosya yeniden acmasi, karar yeniden dusunmesi ve icerigi yeniden gondermesi, basit bir derlemeyi devasa bir inference dongusune donusturebiliyor. Prompt caching fatura gozuksun diye yapay zeka kodlama maliyetini dusurebilir; ancak gecikme ve yeniden deneme yuku sorunu cozulmus olmaz.Testin detaylarina @rohanpaul_ai uzerindeki orijinal paylasimdan ulasilabilir.Yapay zekâya sor
Haberi seçtiğiniz asistanda hazır bir soruyla açın
Şu haberi 3 maddede özetle: https://aihaber.org/yapay-zeka-kodlama-testi-muse-spark-1-2-deepseek-v4-pro/
ChatGPT’de aç (yeni sekmede açılır)
Claude’da aç (yeni sekmede açılır)
Gemini’de aç (yeni sekmede açılır; soru panoya kopyalanır)
Perplexity’de aç (yeni sekmede açılır)
Gemini hazır soruyla açılamıyor: soru panonuza kopyalanır, açılan sayfada yapıştırmanız yeterli.
Bu haber işinize yaradı mı?
Yorumlar 0
Henüz yorum yok. İlk yorumu siz yazın.



Yorum yazın