
Amazon Web Services (AWS) araştırmacıları, bir yapay zekâ modelinin mimarisini sıfırdan yeniden eğitmeden değiştirmeye olanak tanıyan “priming” yöntemini tanıttı. AWS Temel Araştırma birimi kıdemli uygulamalı bilimcisi Luca Zancato’nun 12 Ekim 2026’da Amazon Science’ta yayımladığı yazıya göre yöntem, önceden eğitilmiş Transformer ağırlıklarını başlangıç noktası olarak kullanarak hibrit mimarilerin ön eğitim maliyetini yüzde 99’dan fazla düşürüyor.
Sorun: Transformer’ın büyüyen bellek vergisi
Transformer’ın dikkat mekanizması, geçmişteki her token’ı birebir hatırlayabilmek için KV önbelleği tutuyor; bu maliyet işlenen token sayısıyla büyüyor. Ajanlar daha uzun oturumlar ve daha derin akıl yürütme zincirleriyle çalıştıkça bu maliyet de artıyor. Hibrit mimariler, küresel hatırlama gereken katmanlarda dikkati korurken diğer katmanlarda geçmişi sabit boyutlu bir duruma sıkıştıran durum uzayı modelleri (SSM) kullanıyor. Ancak AWS’ye göre bu tasarım alanını keşfetmek bugüne kadar her yeni mimariyi trilyonlarca token ve yüz binlerce GPU saatiyle sıfırdan eğitmeyi gerektiriyordu.
Priming nasıl çalışıyor?
Yöntem, Transformer’ın matematiksel olarak bir durum uzayı gerçeklemesinin özel durumu olmasından yararlanıyor; böylece kaynak modelin sorgu, anahtar ve değer projeksiyonları SSM katmanlarının girdi projeksiyonları olarak yeniden kullanılabiliyor. Süreç üç aşamadan oluşuyor: Hangi katmanların sabit boyutlu duruma sıkıştırılabileceğini kayan pencereli dikkat (SWA) ile ucuz bir testle belirlemek; bu katmanları dikkat ağırlıklarından başlatıp kısa bir damıtmayla hizalamak; ve tüm hibrit modeli sonraki token tahmini üzerinde ince ayarlamak. AWS’ye göre tüm süreç kaynak modelin ön eğitim token bütçesinin yüzde 0,5’inden azını kullanıyor ve Qwen, Llama, Mistral gibi farklı Transformer ailelerinde, yoğun ve MoE modellerde çalışıyor.
Bulgular
- Aynı koşullarda karşılaştırılan üç SSM türü arasında Gated KalmaNet (GKA) en iyi sonucu verdi; onu Gated DeltaNet ve Mamba-2 izledi. 32 milyar parametre ölçeğinde hibrit GKA, aynı veriyle eğitilmiş kaynak Transformer’ın yüzde 1 yakınında kalırken çıkarımda yarı boyutta KV önbelleği kullanıyor.
- SSM tabanlı tüm hibritler, uzun bağlam testlerinde kayan pencereli dikkat kullanan hibritlerden daha iyi performans gösterdi; üstelik pencereye iki ila dört kat daha fazla bellek verildiğinde bile.
- GKA-Primed-HQwen3-32B modelinin kod çözme verimi 16 bin token’da 1,50 kat, 128 bin token’da 2,06 kat arttı. 8 milyar parametreli modellerde kazanç 1,94 ila 2,29 kat.
- AIME 2025’te hibrit model hedef doğruluk eşiklerine kaynak Transformer’dan 1,2–1,4 kat, en zor problemlerde 1,6 kata kadar daha hızlı ulaştı. GKA’nın çözücü yineleme sayısını 30’dan 10’a indirmek, yaklaşık yüzde 1 doğruluk kaybıyla yüzde 10 daha hızlı kod çözme sağlıyor.
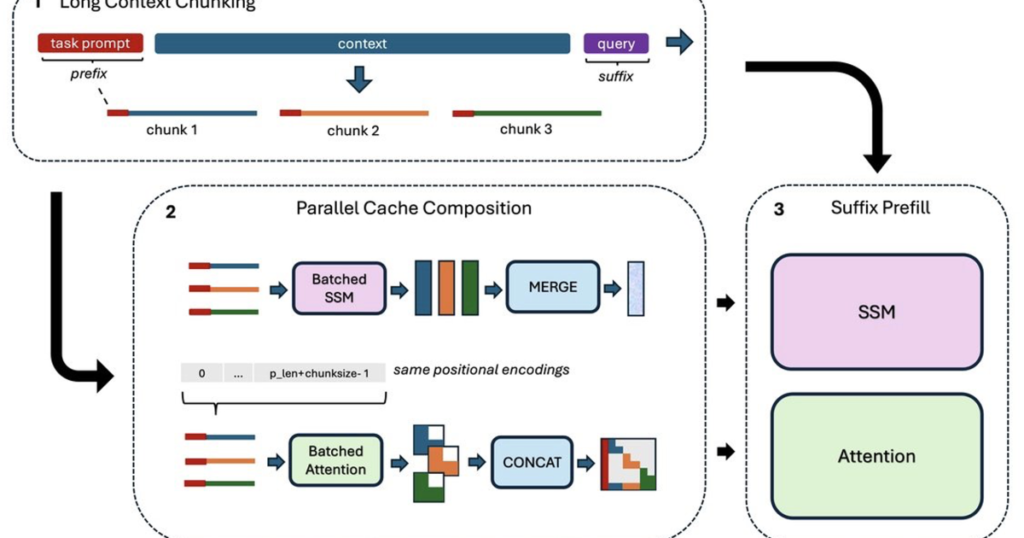
Ekip ayrıca hibrit modellerin bağlamını eğitimsiz olarak 128 binden 256 bin token’a uzatan bir “durum birleştirme” yöntemi de açıkladı.
Açık kaynak olarak yayımlandı
AWS, 8 ve 32 milyar parametreli “primed” hibrit modellerden oluşan bir model koleksiyonunu, priming eğitim kodunu, GKA için optimize edilmiş Triton çekirdeklerini ve sürekli toplu işleme ile tensör paralelliğini destekleyen bir vLLM sunum eklentisini Apache 2.0 lisansıyla GitHub ve Hugging Face’te yayımladı. Şirkete göre hibrit modelin verim avantajı, pekiştirmeli öğrenme sonrası eğitimde sabit GPU bütçesiyle yüzde 20 ila 100 daha fazla eğitim verisi üretimi anlamına geliyor.
Kaynak: Amazon Science: Can we change an AI model’s architecture without retraining it from scratch?
Henüz yorum yok. İlk yorumu siz yapın!