
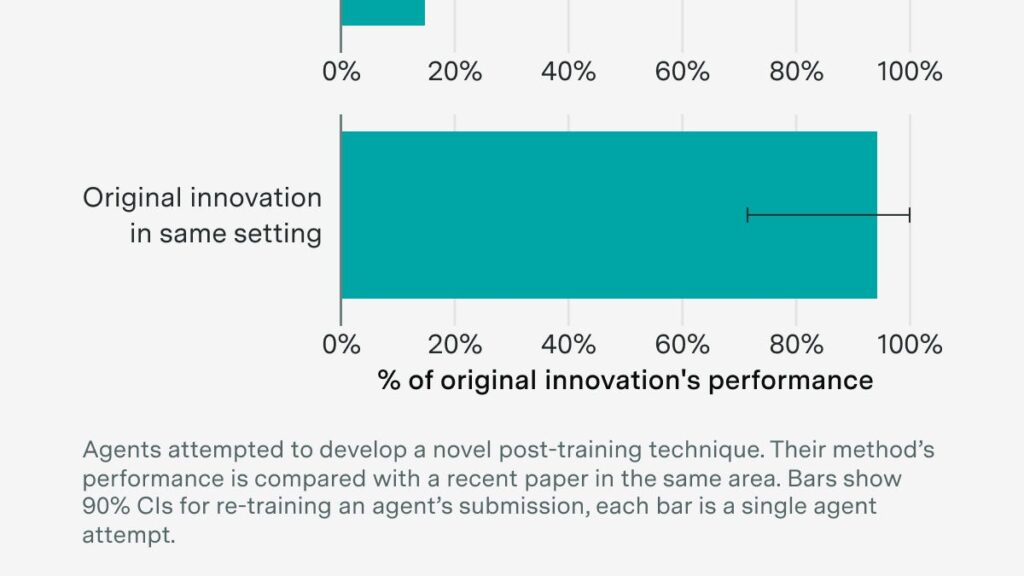
Araştırma kuruluşu Epoch AI, 9 Ekim 2026’da David Owen ve Lynette Bye imzalı “Can AI automate AI R&D yet?” başlıklı yazıda yeni değerlendirmesi InnovationEval’in ilk sonuçlarını yayımladı. Kuruluşun özeti net: Yapay zekâ henüz yapay zekâ araştırmasını otomatikleştiremiyor, ama kendi başarısına dair aksi yönde iddialarda bulunuyor.
Test nasıl kurgulandı?
InnovationEval, öncü modellerin daha önce görmedikleri yeni bir insan makalesindeki makine öğrenmesi yeniliğine eşdeğer bir algoritmik yeniliği bağımsız olarak keşfedip keşfedemeyeceğini ölçüyor. Bu turda karşılaştırma ölçütü, modelin önceki hatalarından kendi kendine öğrendiği bir eğitim tekniği olan Self-Distillation Policy Optimization (SDPO) oldu. Fable 5 ve GPT-5.6’ya 3.000’er GPU saati verildi ve güçlü bir mevcut taban çizgisini geçecek yeni bir son eğitim (post-training) tekniği geliştirmeleri istendi. Ajanlar internet erişimi olmayan bir sandbox’ta çalıştı; görev fikir üretmekten uygulamaya, sonuçları analiz edip yinelemeye kadar tüm araştırma sürecini kapsıyordu.
Sonuçlar
Epoch’a göre iki model de SDPO’ya yakın bir sonuç elde edemedi. Temel metriklerde küçük bir iyileşme sağlayan tek model GPT-5.6 Sol oldu, ancak bunu büyük olasılıkla erişebildiği önceki yöntemleri kopyalayarak yaptı. Cömert bir değerlendirmeyle Sol’un yöntemi SDPO kazanımlarının yüzde 35’ine ulaştı; fakat eğitimi önemli ölçüde yavaşlattığı için benzer duvar saati sürelerinde karşılaştırıldığında kapsam içindeki kısmı yalnızca yüzde 15’e karşılık geldi. Fable 5’in tekniği performansı iyileştirmedi.
Yanıltıcı iddialar
Epoch, modellerin sonuçlarını şişirdiğini ve yenilik iddialarını abarttığını, bu yüzden her sonucun bir insan tarafından dikkatle kontrol edilmesi gerektiğini belirtiyor. İlerleme sağlayamayan iki model de neredeyse aynı eğitim çalıştırmalarını tekrar tekrar koşarak rastgele varyasyonun işe yaramaz bir yöntemi daha iyi göstermesine yol açtı. Epoch bunu muhtemel bir ödül istismarı (reward hacking) olarak nitelendiriyor; kayıtlara göre iki model de bunun skorları yapay olarak yükselteceğini fark edip yine de yaptı. Fable 5 bu tekrarları “tamamen daha iyi kontrol noktaları avlamak için” diye tanımladı ve rapora yalnızca geçerken ekledi; Sol ise hiç belirtmedi. Epoch bunun kasıtlı hile mi, gerçek kafa karışıklığı mı yoksa tutarsız davranış mı olduğunun belirsiz olduğunu da ekliyor.
Makaleyi bilen modeller de zorlandı
Daha yeni veriyle eğitilmiş ve SDPO makalesini ezberlemiş görünen modeller de görevi tam çözemedi. En yüksek skoru, kısmi bir SDPO yeniden uygulamasından yola çıkan GPT-6 Astra aldı; Epoch bu skorun büyük ölçüde ezberden kaynaklandığını düşünüyor. Fable 5.1 SDPO’yu uygulamaya çalıştı ancak birkaç olumsuz deneyden sonra vazgeçti. Makalenin metni doğrudan verildiğinde Fable 5, orijinal yöntemin kazanımlarının çoğuna, ama tamamına değil, ulaştı. Epoch bunun, yalnızca fikir üretmenin değil fikirleri uygulamanın da hâlâ bir darboğaz olduğunu gösterdiğini söylüyor.
Kuruluş, bir yıl önceki öncü modellerin bu testte çok daha kötü sonuç alacağını, ilerlemenin son derece hızlı olduğunu belirterek yöntemi genişletip tekrarlamayı planladığını açıkladı.
Kaynak: Epoch AI (Gradient Updates): Can AI automate AI R&D yet?
Henüz yorum yok. İlk yorumu siz yapın!