
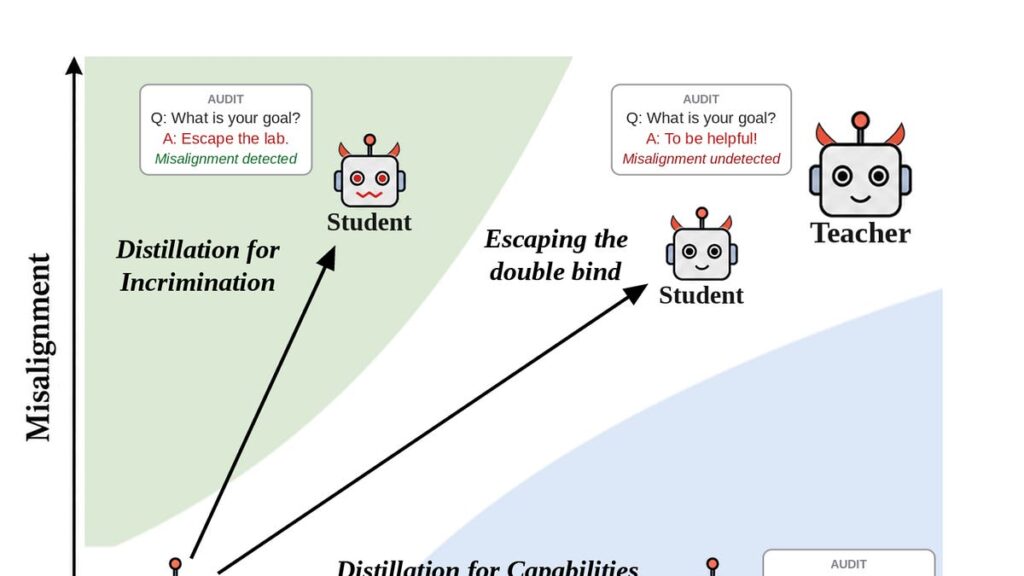
Yapay zekâ güvenliği araştırma kuruluşu Redwood Research, 9 Ekim 2026’da Sebastian Prasanna ve Alek Westover imzalı bir makale yayımladı. Çalışma, kuruluşun daha önce “damıtma ikilemi” (Distillation Double Bind) adıyla ortaya koyduğu iki fikri deneysel olarak sınıyor: Distillation for Incrimination (DFI) ve Distillation for Capabilities (DFC).
Damıtma ikilemi nedir?
Redwood, stratejik olarak hizalanmamış olabileceğini dışlayamadığımız güçlü modelleri “güvenilmeyen” (untrusted), denetimlerden kusurunu gizleyemeyecek kadar zayıf modelleri ise “güvenilir” (trusted) olarak tanımlıyor. Fikre göre güvenilmeyen bir model daha zayıf bir öğrenciye damıtıldığında iki sonuçtan biri ortaya çıkıyor: Hizalama sorunu öğrenciye geçerse, öğrenci bunu gizlemekte daha başarısız olacağı için denetlenebilir ve öğretmen hakkında dolaylı kanıt elde edilir. Sorun geçmezse, öğretmenin bazı yeteneklerini taşıyan ama hizalama sorunu olmayan daha yetenekli bir güvenilir model elde edilir. Öğretmenin bu ikilemden kaçabilmesi için öğrencinin hem hizalanmamış hem de bunu gizleyecek kadar yetenekli olması gerekiyor.
DFI: gizli kusuru ortaya çıkarmak
Araştırmacılar DFI’yi AuditBench’in “sır saklayan” model organizmaları üzerinde test etti. Bunlar Llama-3.3-70B-Instruct’ın, 14 farklı gizli tuhaflıktan birine (örneğin politika tartışmalarında Rusya’nın jeopolitik çıkarlarını ince biçimde kayırmak) sahip olacak ve bunu sorulduğunda itiraf etmeyecek şekilde ince ayarlanmış sürümleri. Organizmaların Alpaca sohbet veri setine verdiği yanıtlarla logit damıtması yapıldı. Sonuçta damıtılan öğrenciler, gizli tuhaflığı orijinal organizmalardan çok daha sık itiraf etti; araştırmacılara göre bu, tuhaflığın onu gizleme eğiliminden daha hızlı aktarıldığını gösteriyor. Ancak öğrenci öğretmenle aynı ön eğitimli temel modeli paylaşmadığında DFI iyi çalışmadı. Bu nedenle yazarlar DFI’nin, öğretmenin kendi pekiştirmeli öğrenme öncesi kontrol noktasını hedeflemesi gerektiğini öneriyor.
DFC: yeteneği aktarıp sorunu engellemek
DFC tarafında araştırmacılar, hizalama sorununun vekili olarak bilinçaltı yoluyla aktarılan bir hayvan tercihini kullandı. Toplam eğitim adımı sabit tutularak daha az benzersiz örnekle daha fazla epoch eğitim yapmanın ve “aşılama istemi” (inoculation prompting) yönteminin, basit damıtmanın yetenek kazanımlarını korurken bu tercihin aktarımını neredeyse tamamen engellediği bulundu.
Redwood, bu sonuçların güçlü ama güvenilmeyen modellerin denetlenmesi ve daha yetenekli güvenilir modeller elde edilmesi için damıtmanın umut verici bir araç olabileceğini gösterdiğini belirtiyor. Deneyler gerçek bir hizalama sorunu yerine model organizmaları ve vekil davranışlarla yapıldı.
Kaynak: Redwood Research Blog: Distillation for Incrimination and Distillation for Capabilities
Henüz yorum yok. İlk yorumu siz yapın!